Votre agent ne devrait peut-être pas être un agent : le test de déterminisme en cinq étapes
Gartner prévoit que plus de 40 % des projets d'IA agentique seront annulés d'ici fin 2027, pour trois raisons données dans le communiqué du 25 juin 2025 : des coûts qui dérapent, une valeur métier floue, des contrôles de risque insuffisants. Le cabinet ajoute un chiffre qui décrit mieux l'état du marché que la prévision elle-même : sur les milliers de fournisseurs qui se présentent comme agentiques, il en estime environ 130 réellement légitimes, le reste relevant de ce qu'il appelle l'agent washing, le rebadgeage d'assistants, de RPA et de chatbots existants. La prévision continue d'être reprise un an plus tard, notamment par Forbes le 7 juillet 2026, signe qu'elle n'a pas été démentie par les déploiements de l'année écoulée.
La lecture habituelle de ce chiffre est que les modèles ne sont pas encore assez bons et que la prochaine génération réglera le problème. Les mesures publiées cette année disent autre chose. Quand on fait tourner deux fois le même agent sur la même tâche, il choisit très majoritairement les mêmes outils dans le même ordre, mais il ne les appelle pas avec les mêmes paramètres, et 60 % de cette divergence apparaît dans les deux premières étapes de la chaîne. Le problème n'est donc pas la longueur de la boucle, ni le nombre d'outils, ni la taille du modèle. Il est à l'entrée. Là où la demande est ambiguë, l'agent apporte quelque chose. Là où elle ne l'est pas, il ajoute de la variance sans ajouter de capacité.
L'article du 2 août sur ce que les event logs révèlent avant de déployer des agents s'arrêtait sur un constat : les équipes qui passent le cap du pilote se servent du modèle miné pour décider quelles étapes restent déterministes. Ce qui suit donne la grille correspondante, cinq questions à poser étape par étape, et surtout les données qui permettent de trancher sans attendre six mois de production.
Ce que les mesures de reproductibilité disent vraiment
Une étude publiée sur arXiv en avril 2026 par Abel Yagubyan a posé la question dans les termes les plus simples possibles : le même agent se comporte-t-il deux fois de la même façon ? Le protocole couvre 19 tâches réparties en cinq catégories, six modèles issus de trois fournisseurs, et 1 140 traces d'exécution. Le résultat tient en deux nombres. La similarité de séquence d'outils, c'est-à-dire la propension à appeler les mêmes fonctions dans le même ordre, atteint 0,87 en moyenne. La cohérence des arguments passés à ces fonctions tombe à 0,69. L'écart entre les deux est large et statistiquement très net.
Trois observations de cette étude comptent plus que les moyennes. D'abord, l'ambiguïté de la formulation de la tâche fait chuter la cohérence des arguments de 28 % par rapport à une tâche structurée, et cet effet dépasse celui du choix du modèle, qui n'atteint pas le seuil de significativité. Choisir un meilleur modèle pour stabiliser un agent revient donc à traiter le second facteur en ignorant le premier. Ensuite, 60 % de la divergence de comportement naît dans les deux premières étapes du pipeline : ce qui se passe après est très largement déterminé par la façon dont l'agent a interprété la demande initiale. Enfin, le texte produit en langage naturel ne correspond presque jamais d'une exécution à l'autre, moins de 5 % de correspondance exacte, y compris quand les séquences d'outils sont identiques. Un test de non-régression qui compare des sorties textuelles mesure du bruit.
L'étude établit aussi un lien direct entre stabilité et justesse : les configurations à forte cohérence structurelle atteignent 90,2 % de réponses correctes, contre 61,2 % pour les configurations à faible cohérence. C'est le point exploitable. Vous pouvez mesurer si une étape a besoin d'un agent avant d'avoir la moindre donnée de vérité terrain, simplement en la relançant vingt fois et en regardant si elle fait la même chose. Une étape qui fait toujours la même chose n'avait pas besoin d'un agent. Une étape qui ne la fait jamais deux fois pareil n'est pas prête à être automatisée sans supervision.
Un second travail, ReliabilityBench, publié sur arXiv en janvier 2026 par Aayush Gupta, mesure la dégradation sous contrainte de production sur 1 280 épisodes, dans quatre domaines métier. De simples reformulations sémantiquement équivalentes de la demande font passer le taux de succès de 96,9 % à 88,1 %. La limitation de débit des API se révèle la panne la plus destructrice de toutes celles injectées. Une réserve s'impose sur ce papier : les modèles évalués, Gemini 2.0 Flash et GPT-4o, appartiennent à une génération antérieure, et les valeurs absolues ont vieilli. L'enseignement de structure, lui, tient : la variance vient autant de l'environnement d'exécution que du modèle, et un benchmark en une seule passe ne mesure aucune des deux.
Le test de déterminisme, cinq questions par étape
La grille s'applique étape par étape, jamais au processus entier. Un processus n'est presque jamais entièrement agentique ou entièrement déterministe ; c'est le découpage qui produit la fiabilité.
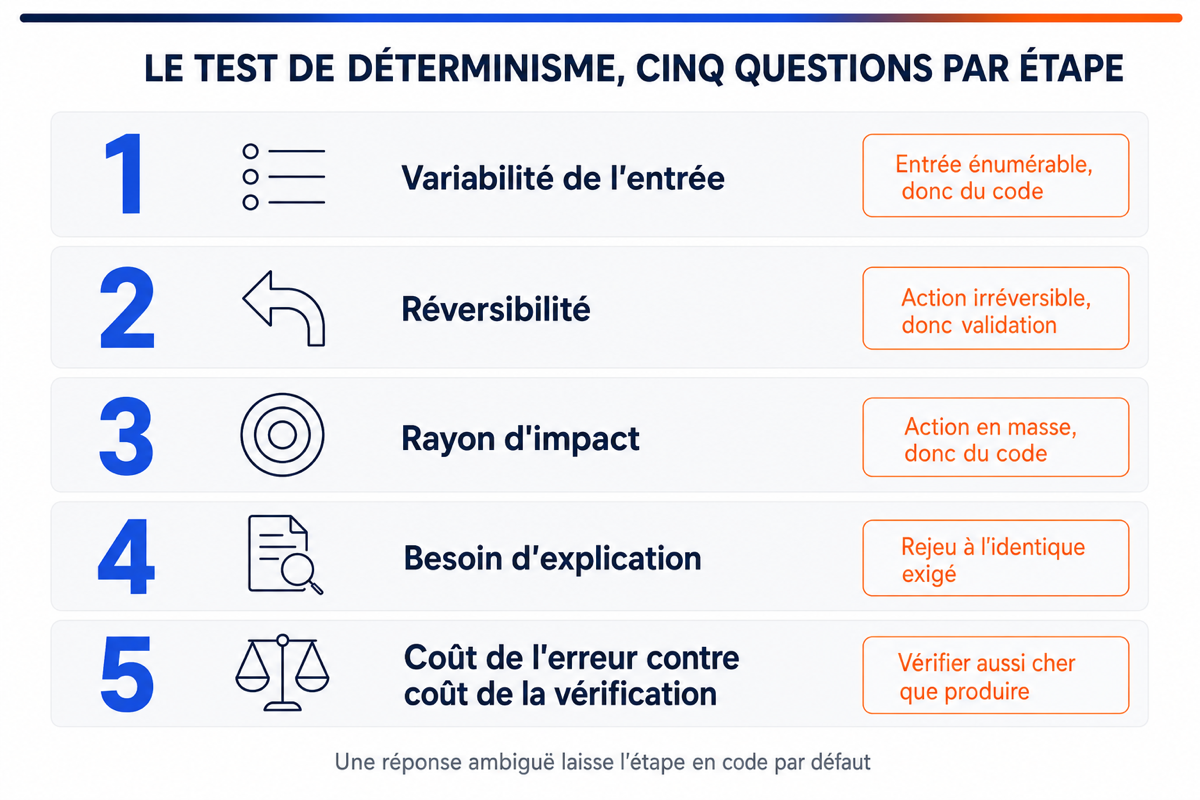
Première question, la variabilité de l'entrée. Pouvez-vous énumérer les formes que prend l'entrée de cette étape ? Si la réponse est oui, même avec une liste longue, vous décrivez une table de routage et vous devriez écrire du code. Le raisonnement probabiliste ne se justifie qu'à partir du moment où la liste est ouverte et où de nouveaux cas apparaissent sans prévenir. C'est la question qui élimine le plus d'étapes, et c'est celle que les projets sautent parce qu'elle a l'air trop simple.
Deuxième question, la réversibilité. L'action peut-elle être annulée, et dans quelle fenêtre ? Une écriture en base annulable en une transaction, un brouillon non envoyé, un ticket qu'on peut rouvrir tolèrent une décision probabiliste. Un virement, un envoi client, une suppression, un engagement contractuel ne la tolèrent pas. La règle pratique est que l'agent propose et que l'exécution irréversible passe par du code avec une validation explicite.
Troisième question, le rayon d'impact. Combien de systèmes et d'enregistrements une seule action touche-t-elle ? Une décision qui affecte un dossier se rattrape, une décision qui déclenche une action en masse ne se rattrape pas. Cette question rejoint directement le cadre de gouvernance décrit dans l'article du 23 juillet sur le framework de risque agentique, à cette nuance près qu'ici elle ne sert pas à autoriser ou refuser l'agent, mais à décider si cette étape précise doit être du code.
Quatrième question, le besoin d'explication. Quelqu'un devra-t-il expliquer cette décision à un tiers, un auditeur, un régulateur, un client, dans un délai contraint ? Si oui, il faut pouvoir rejouer la décision à l'identique. Or les données ci-dessus montrent que le rejeu à l'identique n'est pas ce qu'un agent garantit. Une étape soumise à obligation d'explication appartient au code, ou à un code qui applique une règle que l'agent a proposée en amont et qu'un humain a figée.
Cinquième question, le coût de l'erreur rapporté au coût de la vérification. Si vérifier la sortie coûte aussi cher que la produire, l'agent n'économise rien et déplace simplement le travail. C'est le calcul que la plupart des pilotes ne font pas, et c'est souvent celui qui explique pourquoi un pilote techniquement réussi ne passe jamais à l'échelle.
Ce que les plateformes disent en creux
Les fournisseurs qui vendent des agents décrivent avec une netteté croissante ce que leurs agents ne doivent pas faire. Dans son billet du 7 juillet 2026, Google Cloud recommande de faire basculer vers du code déterministe les parties prévisibles du workflow d'un agent, et pose un principe plus fort encore sur les garde-fous : parce que ces limites sont implémentées comme des contraintes déterministes en dehors du raisonnement de l'agent, elles ne peuvent pas être contournées. Le même texte présente les workflows structurés, avec routage au niveau du code, logique conditionnelle et gestion d'état, comme le mécanisme qui produit la prévisibilité, l'agent intervenant à l'intérieur de ce cadre et non à sa place.
Oracle a annoncé le 14 juillet 2026 une extension de son AI Agent Studio pour Fusion Applications, en défendant une thèse voisine sur le plan architectural : les applications agentiques s'exécutent nativement dans le système d'entreprise, héritent de ses objets métier, de ses workflows, de ses approbations et de sa traçabilité. Chris Leone, executive vice president Applications Development, le formule comme une opposition explicite : construire des automatisations IA déconnectées puis tenter d'y greffer des contrôles d'entreprise après coup relève d'une approche fondamentalement différente. Il faut lire cela pour ce que c'est, un argument commercial d'un éditeur d'ERP, mais l'argument est cohérent avec les données de reproductibilité : l'approbation, la piste d'audit et l'exécution transactionnelle sont précisément ce qui ne supporte pas la variance.
Ce n'est pas une position nouvelle. Anthropic écrivait déjà, dans sa note d'ingénierie sur la construction d'agents efficaces, qu'il faut chercher la solution la plus simple possible et n'augmenter la complexité qu'en cas de nécessité, ce qui peut vouloir dire ne pas construire de système agentique du tout. La différence entre 2024 et aujourd'hui, c'est qu'on dispose enfin de mesures pour arbitrer, plutôt que d'un principe de sobriété que tout le monde approuve et que personne n'applique.
Sur le terrain, le schéma qui revient dans les déploiements qui tiennent est toujours le même. Le routage, les seuils de coût, les permissions, les validations transactionnelles et la journalisation sortent du périmètre de l'agent et restent du code. L'agent garde l'interprétation d'une demande formulée librement, la synthèse d'informations hétérogènes, la rédaction, et la proposition d'un plan que quelqu'un d'autre exécute. Les équipes qui échouent ne se sont pas trompées de modèle, elles ont confié à un composant probabiliste des décisions qui avaient une bonne réponse connue à l'avance.
À mettre en route cette semaine
Prenez l'agent le plus avancé de votre feuille de route et décomposez-le en étapes nommées, avec pour chacune son entrée, sa sortie et son effet de bord. Si personne dans l'équipe ne peut produire cette liste en une heure, le problème n'est pas le modèle.
Appliquez les cinq questions à chaque étape et notez en face de chacune une seule décision : code, agent, ou agent sous validation humaine. Une étape qui reçoit une réponse ambiguë reste du code par défaut, la charge de la preuve appartient à l'agent.
Lancez un test de cohérence avant d'ouvrir un débat d'architecture. Rejouez vingt fois la même demande sur les étapes candidates, comparez les séquences d'outils et les arguments, jamais le texte produit. Le coût est de quelques heures et le résultat tranche plus vite qu'une réunion.
Ajoutez une perturbation à ce test. Reformulez la même demande de cinq façons équivalentes et relancez. C'est le protocole de ReliabilityBench réduit à l'essentiel, et c'est ce qui sépare une démonstration d'un composant de production.
Écrivez enfin, pour les étapes qui restent agentiques, la contrainte déterministe qui les encadre : plafond d'itérations, périmètre de permissions, seuil de coût, liste d'actions irréversibles interdites. Si cette contrainte vit dans le prompt système, elle n'existe pas.
Conclusion
La course à l'agent a produit un réflexe de conception qui consiste à demander comment rendre l'agent plus fiable, alors que la question utile est de savoir quelles étapes n'auraient jamais dû lui être confiées. Les données de 2026 donnent enfin de quoi trancher sans attendre l'incident : une étape qui se rejoue à l'identique n'avait pas besoin d'intelligence, une étape qui diverge dès le deuxième appel n'est pas prête, et la frontière entre les deux se lit à l'entrée du processus, là où l'ambiguïté existe ou n'existe pas. Le meilleur agent que vous livrerez cette année sera probablement celui qui aura le moins d'étapes.
Sources : As of July 2026
- [Primary] How Consistent Are LLM Agents? Measuring Behavioral Reproducibility in Multi-Step Tool-Calling Pipelines — Abel Yagubyan (arXiv:2605.28840) — avril 2026 — https://arxiv.org/abs/2605.28840
- [Primary] ReliabilityBench: Evaluating LLM Agent Reliability Under Production-Like Stress Conditions — Aayush Gupta (arXiv:2601.06112) — 3 janvier 2026 — https://arxiv.org/abs/2601.06112
- [Primary] 20 questions for the Agentic Enterprise (and how Agent Platform can help) — Google Cloud — 7 juillet 2026 — https://cloud.google.com/blog/products/ai-machine-learning/20-questions-for-the-agentic-enterprise
- [Primary] Oracle Introduces AI-Native Builder Experience to Create and Run Agentic Applications in Oracle Fusion Applications — Oracle — 14 juillet 2026 — https://www.oracle.com/news/announcement/oracle-introduces-ai-native-builder-experience-2026-07-14/
- [Primary] Building effective agents — Anthropic — 19 décembre 2024 — https://www.anthropic.com/engineering/building-effective-agents
- [Primary] Gartner Predicts Over 40% of Agentic AI Projects Will Be Canceled by End of 2027 — Gartner — 25 juin 2025 — https://www.gartner.com/en/newsroom/press-releases/2025-06-25-gartner-predicts-over-40-percent-of-agentic-ai-projects-will-be-canceled-by-end-of-2027
- [Secondary] Why 40% Of Agentic AI Projects May Be Canceled By 2027 — Robert Szczerba, Forbes — 7 juillet 2026 — https://www.forbes.com/sites/robertszczerba/2026/07/07/why-40-of-agentic-ai-projects-may-be-canceled-by-2027/
Comments ()