Votre sandbox reste chez vous, vos données partent quand même aux États-Unis
Le 10 septembre 2026, OpenAI a ouvert l'Agents API en bêta publique. L'offre expose en service managé le harness qui fait tourner Codex : orchestration des sessions, compaction automatique du contexte, recherche d'outils, appels d'outils programmatiques, sous-agents parallèles, reprise de session. Le point d'architecture mis en avant dans l'annonce est un découplage. OpenAI héberge et maintient le harness, vous choisissez où tourne le calcul, dans un bac à sable managé par OpenAI, sur votre propre infrastructure, ou chez l'un des neuf partenaires annoncés : Blaxel, Cloudflare, Daytona, DigitalOcean, E2B, Modal, Oracle, Runloop et Vercel. Il n'y a pas de frais d'API supplémentaire, vous payez les jetons, les outils et le conteneur.
Ce découplage a été lu un peu partout comme la réponse aux contraintes de localisation : gardez le bac à sable dans votre VPC et la question est réglée. La documentation d'OpenAI dit le contraire, en une phrase, en bas de la page de présentation de l'API. L'Agents API ne prend en charge la résidence des données qu'aux États-Unis, ne prend pas en charge le Zero Data Retention, et choisir un bac à sable auto-hébergé ne rend pas l'Agents API éligible au ZDR. La phrase est écrite par le fournisseur lui-même, elle n'est pas une lecture d'analyste.
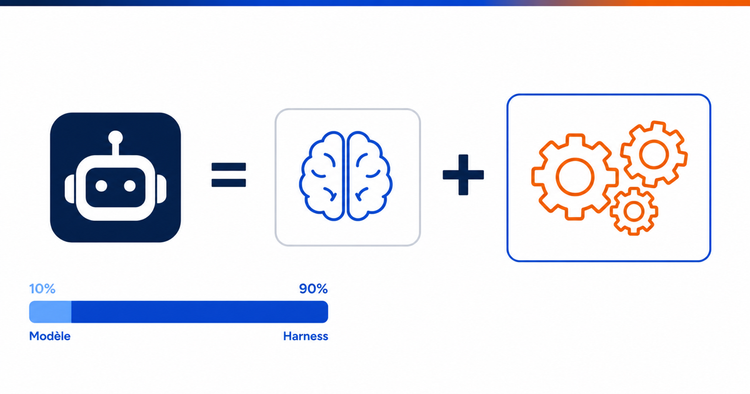
Ce n'est pas un détail de bêta, c'est une conséquence de l'architecture, et elle mérite d'être comprise avant de recâbler quoi que ce soit. L'article du 1er juillet soutenait que le harness, et non le modèle, détermine le comportement d'un agent. Si cette thèse tient, alors externaliser le harness n'est pas un arbitrage d'implémentation, c'est le transfert de la couche qui décide. Reste à savoir ce que ce transfert donne réellement, ce qu'il verrouille, et à quelles conditions il vaut le coup.
Ce que le bac à sable auto-hébergé contrôle, et ce qu'il ne contrôle pas
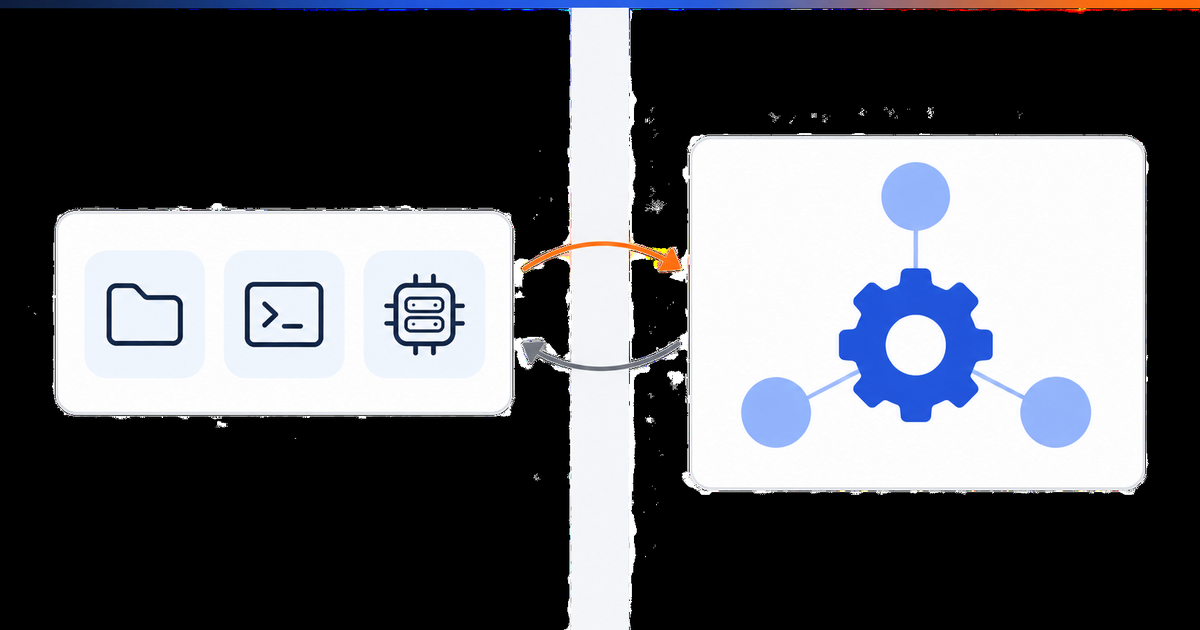
Le mécanisme est documenté précisément, ce qui permet de raisonner sans supposition. OpenAI fait tourner le harness. Vous faites tourner un exécuteur, codex exec-server, à l'intérieur de votre environnement. Cet exécuteur lance des commandes shell, lit et écrit des fichiers, et appelle vos serveurs MCP locaux, à la demande du harness. Il s'enregistre auprès de l'API avec un identifiant d'environnement et une clé restreinte, puis ouvre une connexion WebSocket pour recevoir des commandes et renvoyer des résultats. Toutes les connexions sont sortantes, vers api.openai.com pour l'enregistrement et vers wss://codex-cloud-environments.chatgpt.com pour le trafic de travail.
Lu attentivement, ce schéma dit que votre environnement est un exécutant, pas un décideur. Le harness décide quelle commande lancer, quel outil appeler, quand déléguer à un sous-agent et quoi conserver du contexte. Votre côté exécute et renvoie le résultat. Le résultat traverse donc la connexion sortante et arrive chez OpenAI, où la session est conservée pour permettre la reprise entre les tours. C'est même la promesse explicite de la page de documentation : l'Agents API conserve l'état de session pour que vous puissiez continuer le travail sans reconstruire le contexte de conversation, et vous pouvez supprimer les sessions et les artefacts publiés quand vous n'en avez plus besoin.
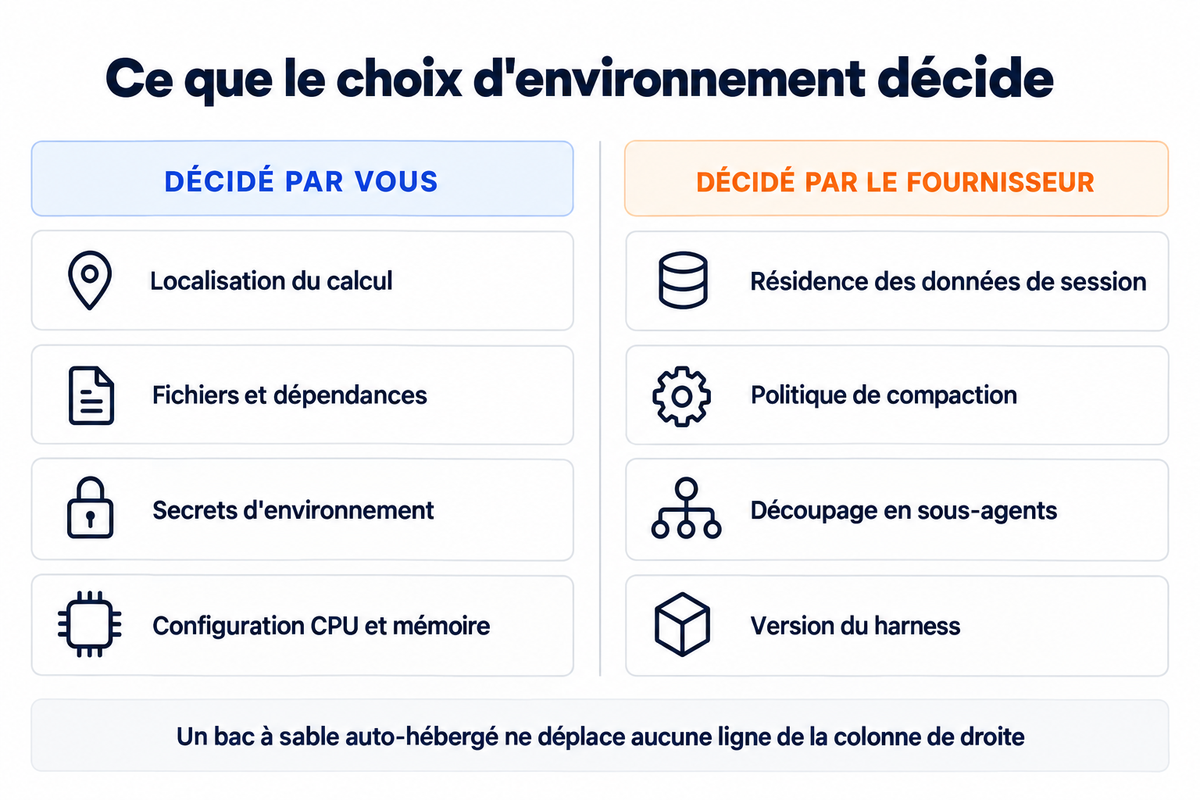
Autrement dit, le bac à sable auto-hébergé est un contrôle de calcul et de fichiers au repos, pas un contrôle de gouvernance des données en transit. Vos fichiers restent sur votre disque, vos dépendances restent dans votre image, vos secrets d'environnement restent chez vous. Mais tout ce que l'agent lit et renvoie pour avancer devient du contenu de session côté fournisseur. Pour beaucoup de charges de travail, cela n'a aucune importance. Pour une charge qui manipule des données clients dans un secteur régulé, c'est précisément la question qui compte.
Les mots de cette architecture
Harness : la couche qui pilote l'agent autour du modèle, choisit les outils, gère le contexte, coordonne les sous-agents et décide quand s'arrêter. C'est là que se joue l'essentiel du comportement observé.
Exécuteur : le processus qui exécute réellement les commandes du harness dans un environnement donné. Ici, la commande codex exec-server, lancée à l'intérieur de votre infrastructure.
Compaction : le résumé automatique de l'historique quand une session approche de la limite de contexte, pour que l'agent puisse continuer au-delà d'une fenêtre.
Résidence des données : la garantie que le contenu client est stocké au repos dans une région donnée. Zero Data Retention : l'engagement que les requêtes et les réponses ne sont pas stockées au repos du tout. Les deux sont distincts et se demandent séparément.
La phrase de documentation qui annule l'argument de souveraineté
Il faut mesurer l'écart avec le reste de la plateforme du même fournisseur. Depuis le 25 novembre 2025, OpenAI propose la résidence des données en Europe, au Royaume-Uni, aux États-Unis, au Canada, au Japon, en Corée du Sud, à Singapour, en Inde, en Australie et aux Émirats arabes unis, pour ChatGPT Enterprise, ChatGPT Edu et la plateforme API. Sur la plateforme API, un client entreprise approuvé pour les contrôles de données avancés crée un nouveau projet, choisit sa région, et les requêtes de ce projet sont traitées en région sans stockage au repos chez OpenAI.
L'Agents API sort de ce cadre. Sa page de présentation indique qu'elle ne prend en charge la résidence des données qu'aux États-Unis et qu'elle ne prend pas en charge le ZDR, puis ajoute la précision qui ferme la porte de sortie habituelle : choisir un bac à sable auto-hébergé ne rend pas l'Agents API éligible au ZDR. Une équipe qui a obtenu la résidence européenne sur ses projets API existants ne la transporte donc pas en migrant vers l'Agents API. Le service managé est un périmètre différent, avec ses propres garanties, plus faibles sur ce point précis à la date d'écriture.
C'est l'inversion la plus utile à retenir de tout ce lancement. L'annonce présente le choix de l'environnement comme la décision d'architecture principale, et elle a raison pour le calcul, le stockage des fichiers, la configuration CPU et GPU, le temps de démarrage à froid et le coût. Elle ne l'est pas pour la localisation des données de session, qui ne dépend pas du tout de ce choix. Deux questions que tout le monde traite comme une seule.
Louer le harness, c'est aussi louer sa politique de compaction
Le harness managé résume votre historique à votre place. La page de présentation liste explicitement, parmi ses fonctions, le fait de résumer le travail précédent pour gérer la fenêtre de contexte, et l'annonce précise que l'API compacte automatiquement le contexte antérieur à l'approche de la limite, pour que les développeurs n'aient pas à écrire leur propre logique de compaction. Présenté comme un gain de temps, ce qui est vrai.
Sauf que cette couche n'est pas neutre. L'article du 5 septembre le documentait à partir d'un travail académique : sur le benchmark ConstraintRot, 1 323 épisodes et sept familles de modèles, le taux de violation d'une contrainte de gouvernance passe de 0 % quand la politique est entièrement dans le contexte à 30 % après compaction, et jusqu'à 59 % sur certains modèles. Quand la contrainte survit au résumé, la violation reste à 0 %. Quand elle est supprimée, elle monte à 38 %. La conclusion pratique était que la couche de gestion du contexte est une surface de gouvernance à part entière, pas un réglage d'optimisation de jetons.
Externaliser le harness, c'est donc confier cette surface au fournisseur. Ce n'est pas nécessairement une mauvaise affaire : une équipe qui écrit sa propre compaction fait rarement mieux qu'un fournisseur qui a industrialisé la question sur des millions de sessions. Mais c'est une décision de gouvernance qui doit être prise comme telle, avec une contrepartie explicite. Le harness Codex est open source et son dépôt public est inspectable, ce qui rend l'audit possible, à la condition de le faire.
Un point mérite d'être signalé sans être surinterprété. L'annonce promet un accès versionné aux capacités du harness à chaque sortie de modèle, et un harness maintenu et amélioré en continu au rythme des modèles. La page de documentation de l'API, elle, ne documente pas de mécanisme permettant d'épingler une version de harness : la seule chose qui ressemble à un numéro de version est l'en-tête de bêta OpenAI-Beta: agents=v1 présent dans les exemples. Il est possible que ce mécanisme existe ailleurs ou arrive plus tard. En l'état de ce qui est publié, la question mérite d'être posée au fournisseur avant de s'engager, parce qu'un harness qui bouge sous vos pieds est un changement de comportement non versionné sur la couche qui décide.
Cinq critères pour trancher entre louer et construire
Le premier critère est le coût de maintenance que vous supprimez. Un harness maison doit être retouché à chaque évolution de modèle, et ce travail sort du budget qui améliore votre produit. C'est l'argument le plus solide en faveur de la location, et il pèse d'autant plus lourd que votre équipe est petite. Les chiffres publiés par OpenAI vont dans ce sens, avec une évaluation passée de 0,71 à 0,85 chez Ciridae, un coût par dossier en baisse de 60 % chez SafetyKit et 86 % de réponses en échec en moins chez Hypha. Ce sont des témoignages fournis par le vendeur sur sa propre page produit, pas des mesures indépendantes, et ils se lisent comme tels.
Le deuxième est la localisation et la rétention. Si votre charge tombe sous une exigence de résidence européenne ou de non-rétention, la réponse est écrite dans la documentation et elle est négative aujourd'hui, quel que soit l'endroit où tourne votre bac à sable. Ce critère est binaire et il s'évalue en premier, parce qu'il rend les quatre autres sans objet quand il bloque.
Le troisième est le contrôle de la compaction et de la rétention de contexte. Demandez comment sont journalisés les résumés, si le contenu du résumé est consultable après coup, et ce qui se passe pour une contrainte de politique posée en début de session. Sans réponse à ces trois questions, vous ne pourrez pas reconstituer une décision d'agent après incident.
Le quatrième est la portabilité et le coût de sortie. Le harness est open source, ce qui rend techniquement possible de le rapatrier, mais l'état de session, la configuration des sous-agents et les artefacts publiés vivent côté fournisseur. Chiffrez ce que coûterait un rapatriement avant d'avoir des agents en production, pas après.
Le cinquième est l'observabilité des sous-agents. Chaque sous-agent conserve son propre contexte et l'agent principal coordonne. C'est efficace et c'est opaque : si vos journaux ne conservent que la sortie du coordinateur, vous perdez la trace de ce que chaque sous-agent a réellement fait. Sur ce point, la fragmentation des plateformes d'orchestration traitée le 30 août reste le bon cadre de lecture.
Un dernier élément, rarement mentionné, mérite d'être écrit dans la grille. La documentation sur les bacs à sable auto-hébergés demande d'isoler les environnements par utilisateur ou par charge de travail, parce que des agents qui partagent un environnement accèdent aux mêmes fichiers, aux mêmes identifiants et aux mêmes ressources. Un environnement partagé par commodité est un contournement silencieux de tout ce que vous aurez écrit par ailleurs.
À mettre en route cette semaine
Ouvrez la page de présentation de l'Agents API et lisez le paragraphe de rétention jusqu'au bout, avec la personne qui porte la conformité chez vous et pas seulement avec l'équipe plateforme. Sur le terrain, la décision d'adopter une API d'agents se prend en général sur un critère de vitesse d'intégration, et la question de la résidence remonte six semaines plus tard, portée par un juriste qui ouvre la page que personne n'avait lue.
Classez vos charges agentiques en deux tas avant toute évaluation technique : celles qui manipulent des données soumises à une exigence de localisation ou de non-rétention, et les autres. Le premier tas n'est pas candidat à la migration aujourd'hui, quelles que soient les performances mesurées. Cette séparation prend une heure et évite un pilote qui ne pourra jamais passer en production.
Si vous testez, testez avec l'exécuteur auto-hébergé plutôt qu'avec le bac à sable managé, même quand le managé serait plus rapide à mettre en route. C'est la configuration qui révèle la charge réelle d'exploitation : gestion de la clé d'environnement, reconnexions, hôtes sortants à autoriser, isolation par charge de travail, cycle de vie du conteneur.
Créez la clé d'environnement séparément de la clé applicative, avec toutes les autres permissions à None, et gardez la clé applicative en dehors du bac à sable. La documentation précise que du code généré par l'agent peut lire la clé d'environnement, et que cette clé ne permet que de connecter un environnement. Cette séparation n'a d'intérêt que si elle est faite dès le premier essai, parce qu'elle ne se rattrape jamais ensuite.
Posez trois questions écrites au fournisseur avant tout engagement : existe-t-il un moyen d'épingler une version de harness, la durée de conservation des sessions est-elle contractuelle, et le contenu des résumés de compaction est-il exportable. Les réponses valent mieux qu'une estimation, et l'absence de réponse est elle-même une information utile pour la décision.
Conclusion
L'Agents API est une bonne nouvelle pour la plupart des équipes : elle supprime une couche coûteuse à maintenir et elle le fait sur une base open source inspectable. Mais elle déplace le point de décision plutôt qu'elle ne le supprime, et le déplacement est moins lisible qu'il n'y paraît. Ce qui se loue n'est pas un service d'exécution, c'est la couche qui choisit les outils, découpe le travail et décide de ce qu'il faut oublier, avec une session qui vit aux États-Unis même quand le calcul reste chez vous. La thèse du 1er juillet ne tombe pas, elle se retourne : si le harness détermine le comportement et qu'il devient un produit sur étagère, alors ce qui vous distingue est ce qui reste de votre côté du WebSocket, c'est-à-dire vos outils, votre connaissance métier et vos données.
Sources : As of : Septembre 2026
- [Primary] Introducing the Agents API — OpenAI — 10 septembre 2026 — https://openai.com/index/introducing-the-agents-api/
- [Primary] Agents API, documentation de référence, sections Core concepts, Pricing et rétention — OpenAI — consultée le 17 septembre 2026 — https://developers.openai.com/api/docs/guides/agents-api/overview
- [Primary] Self-hosted sandboxes, exécuteur codex exec-server, authentification et accès réseau — OpenAI — consultée le 17 septembre 2026 — https://developers.openai.com/api/docs/guides/agents-api/environments/self-hosted
- [Primary] Compaction, documentation de référence — OpenAI — consultée le 17 septembre 2026 — https://developers.openai.com/api/docs/guides/compaction
- [Primary] Expanding data residency access to business customers worldwide — OpenAI — 25 novembre 2025 — https://openai.com/index/expanding-data-residency-access-to-business-customers-worldwide/
- [Primary] Data controls in the OpenAI platform — OpenAI — consultée le 17 septembre 2026 — https://developers.openai.com/api/docs/guides/your-data
- [Primary] Codex, dépôt public du harness — OpenAI — consulté le 17 septembre 2026 — https://github.com/openai/codex
- [Primary] Governance Decay: How Context Compaction Silently Erases Safety Constraints in Long-Horizon LLM Agents — Shiyang Chen, arXiv:2606.22528 — v1 21 juin 2026, v2 27 juin 2026 — https://arxiv.org/abs/2606.22528
- [Secondary] OpenAI Launches the Agents API in Public Beta, Putting the Codex Harness Behind One API Call — MarkTechPost — 10 septembre 2026 — https://www.marktechpost.com/2026/09/10/openai-launches-the-agents-api-in-public-beta-putting-the-codex-harness-behind-one-api-call/
Comments ()