Sept pour cent des appels de votre agent portent 68 % de sa facture
NVIDIA a publié le 11 août 2026 Nemotron 3.5 Lightning, un modèle ouvert de 30 milliards de paramètres dont 3 milliards actifs, présenté sans détour comme destiné à la couche d'exécution des agents en boucle longue. Le billet technique pose la thèse en une phrase : un agent qui tourne en continu passe l'essentiel de son temps sur des appels d'outils, de la validation de résultats et de la délégation à des sous-agents, et faire tourner un modèle de raisonnement frontière sur chacune de ces étapes ajoute du coût et de la latence. Le même jour, LangChain publiait une mesure sur sa suite d'évaluation d'agents : sur 145 tâches multi-tours, 7 % des tours seulement ont été envoyés au modèle frontière, et ces 7 % ont porté 68,4 % de la dépense.
Le réflexe devant ces deux chiffres est d'en conclure qu'il faut router. Les données publiées par LangChain méritent une lecture moins rapide. Le bras routé obtient 80,0 % de justesse contre 86,0 % pour le modèle frontière seul, et 77,7 % pour le petit modèle utilisé seul sur toutes les tâches. Le routage gagne donc 2,3 points sur l'option la plus simple, quand la variance d'un run à l'autre est de 2,7 points. Sur cette charge de travail, LangChain écrit explicitement qu'il ne peut pas affirmer que le routage a battu le petit modèle. Ce que le routage achète n'est pas un gain de justesse, et pas non plus une économie moyenne : c'est un plafond de coût quand vous ne savez pas à l'avance quelle requête est difficile.
L'article du 3 juillet sur les coûts d'inférence traitait le sujet par levier technique, celui du 11 juillet sur le budget de tokens prenait la session comme unité. L'unité utile ici n'est ni le token ni le levier, c'est l'étape de trajectoire. Ce qui suit détaille ce que trois mesures indépendantes disent réellement, la formule qui décide avant l'architecture, et la méthode d'audit à passer sur vos propres traces.
Ce que recouvre la couche d'exécution
Nemotron 3.5 Lightning est un modèle à mélange d'experts de 30 milliards de paramètres dont 3 milliards s'activent par token, distillé du modèle frontière de la même famille, avec une architecture hybride qui alterne couches Mamba-2, couches d'experts et couches d'attention. Les poids, les données d'entraînement et les recettes sont publiés sous licence OpenMDW-1.1, avec un point de contrôle NVFP4 aux côtés du BF16, ce qui le rend déployable d'un poste de travail à un centre de données.
Les mots de l'architecture
Mélange d'experts (MoE) : architecture où un routeur interne n'envoie chaque token qu'à une petite partie des sous-réseaux du modèle. On obtient la capacité d'un grand modèle au coût de calcul d'un petit.
Paramètres actifs : la fraction des paramètres réellement utilisée pour produire un token. Ici 3 milliards sur 30, soit un dixième.
Harnais : la couche logicielle qui entoure le modèle et décide comment il reçoit son contexte, appelle ses outils et enchaîne ses tours. Elle détermine le comportement d'un agent autant que le modèle lui-même.
Décodage spéculatif : un petit modèle propose plusieurs tokens d'avance, le modèle complet les vérifie en une passe. Sortie identique, génération plus rapide.
Deux points de cette publication méritent l'attention d'une direction technique plus que les chiffres de vitesse. Le premier est l'entraînement spécifique au harnais : le modèle a été entraîné pour des harnais d'agents nommés, ce qui prolonge directement ce que l'article du 5 juillet sur l'ingénierie de harnais décrivait comme le déterminant principal du comportement d'un agent en production. Le second est la publication simultanée de NeMo Switchyard, une bibliothèque de routage ouverte qui expose ce petit modèle comme cible de routage à côté de vos modèles fermés, avec des stratégies qui lisent l'état de l'agent tour par tour plutôt qu'une catégorie de tâche fixée à la conception.
La modestie du positionnement est à porter au crédit du fournisseur. Sur l'indice de capacité générale d'Artificial Analysis, qui agrège neuf évaluations, Lightning obtient 24, à égalité avec gpt-oss-120b et derrière plusieurs modèles de sa classe de taille situés à 30. NVIDIA ne prétend pas au contraire, et sa revendication est étroite : sur PinchBench, une justesse de 86 % en complétant 10 000 tâches 30 % plus vite qu'un concurrent de taille comparable à justesse équivalente. C'est un arbitrage vitesse contre justesse, pas une victoire de capacité, et il faut rappeler que ce chiffre provient du fournisseur lui-même.
Trois mesures, trois résultats très différents
Les tests publiés par des tiers donnent une image plus utile que le billet du fournisseur, parce qu'ils divergent.
LangChain a fait tourner sa suite de 145 tâches agentiques multi-tours, d'une moyenne de 6,3 appels de modèle chacune, à travers le routeur en mode escalade. Le modèle frontière seul obtient 86,0 % pour 11,45 dollars par run. Le routage obtient 80,0 % pour 3,00 dollars. Le petit modèle seul obtient 77,7 % pour 0,72 dollar. Le petit modèle a traité 93 % des appels pour 10,4 % de la dépense. Une réserve importante accompagne ces chiffres, et LangChain la pose lui-même : la suite est saturée, seuls 8 points séparent le petit modèle du modèle frontière, ce qui laisse au routage moins d'espace pour démontrer sa valeur qu'une charge plus difficile.
Le poste de coût que personne n'anticipe est le modèle juge. Il tourne à chaque tour tant qu'une tâche n'a pas escaladé, il ne bénéficie d'aucune mise en cache de prompt, et il représente 21,2 % de la dépense du bras routé, soit le deuxième poste après le modèle frontière. Votre routeur a un impôt, et cet impôt se paie même quand aucune escalade ne survient.
La dispersion est le second enseignement. Sur cinq runs identiques, la part de trafic envoyée au modèle frontière a varié de 4,1 % à 9,1 %, et le coût de 2,16 à 3,61 dollars. Rien n'avait changé sinon les décisions du routeur, et la facture a bougé de 67 %. Un routeur abaisse votre dépense moyenne et élargit l'intervalle autour d'elle, ce qui impose de budgéter le haut de la fourchette plutôt que la moyenne.
Deux autres retours, rapportés par VentureBeat à partir des chiffres partagés par NVIDIA, donnent des ordres de grandeur nettement plus resserrés. Ramp indique avoir égalé la performance d'un modèle frontière sur son propre banc d'ingénierie logicielle en réduisant les coûts de 58 % et le temps d'exécution de 33 %. Cognition a intégré le routage par étapes dans son produit de bureau et rapporte une performance proche du frontière sur son banc de tâches de code, avec un coût moyen inférieur de 28 %. L'écart entre 28 % et 74 % n'est pas du bruit : il dit que le gain n'est pas une propriété du routeur, c'est une propriété de votre mélange de trafic.
La formule à calculer avant de toucher à l'architecture
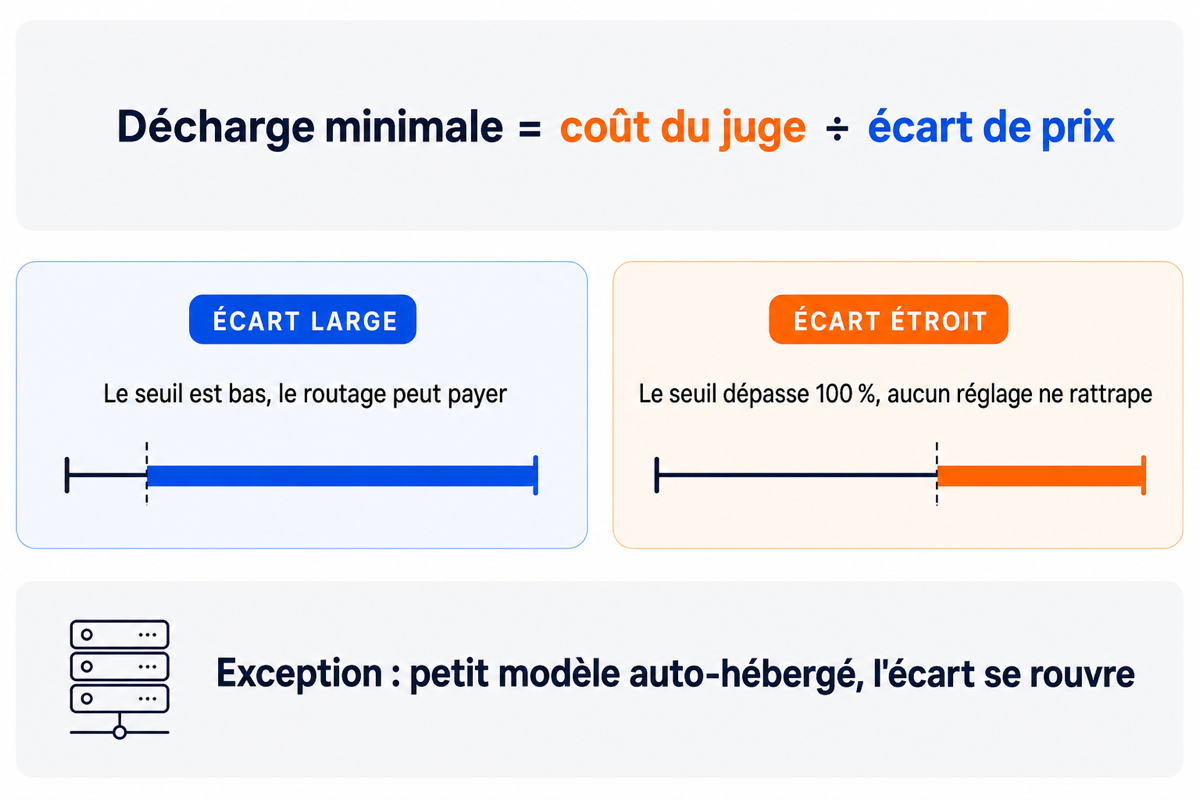
LangChain publie, avec ses résultats, la seule chose vraiment transposable de tout le dossier. Le routage ne réduit le coût total par rapport au modèle frontière seul que si la part de tours envoyés au petit modèle dépasse ce seuil :
décharge minimale = coût du juge / (coût du modèle cher - coût du modèle bon marché)
Sur leur configuration, le juge coûtait 0,64 dollar par run pour un écart de prix de 10,73 dollars, soit un seuil de 5,9 %. Ils ont déchargé 93 % des tours et franchi la barre d'un facteur seize. Avec un couple aussi déséquilibré, la formule tient de la formalité. Elle devient décisive quand l'écart se resserre.
Son intérêt principal est négatif, et c'est ce qui la rend utile en comité d'architecture. Si vos deux modèles sont proches en prix, l'économie par tour déchargé est faible et la formule vous demande d'envoyer plus de 100 % de vos tours au modèle bon marché, ce qu'aucun réglage ne permet. Aucune configuration de juge ne rattrape cela. La seule exception est un petit modèle hébergé chez vous, dont le coût d'inférence marginal tombe assez bas pour rouvrir l'écart. C'est le point où le caractère ouvert des poids cesse d'être un argument de souveraineté pour devenir un argument d'économie, et les deux se renforcent : les étapes à fort volume sont aussi celles dont la donnée reste le plus facilement chez vous.
Thoughtworks, partenaire d'accès anticipé, chiffre cette voie sur ses propres essais. Ses équipes ont post-entraîné deux adaptateurs de domaine, juridique et santé, en quelques heures sur un seul nœud de huit GPU, sans qu'aucune donnée ne quitte leur environnement, avec un modèle adapté préféré au modèle de base dans 75 % des comparaisons aveugles côté juridique. Sur la vitesse, elles mesurent que le décodage spéculatif livré par défaut multiplie le débit par 1,46 à 1,96 selon la charge, ce qui divise à peu près par deux le coût GPU par token généré sur matériel auto-hébergé. Le fait notable est ailleurs : leur propre modèle de brouillon entraîné spécifiquement n'a fait qu'égaler celui fourni par défaut, ce qui est rare et retire un chantier d'optimisation de la liste.
Cette formule permet d'écarter le routage sur des bases de coût. Elle ne permet pas de l'adopter. Pour cela, il faut regarder vos trajectoires, et c'est là que le travail commence.
Sur le terrain, les équipes qui ouvrent réellement leurs traces découvrent une distribution qui ne ressemble pas au schéma d'architecture qu'elles avaient dessiné. Les étapes qui consomment le plus de tokens sont rarement celles que l'équipe décrit comme l'intelligence de l'agent. Ce sont les relectures de contexte, les mises en forme de résultat et les validations de sortie d'outil. La plupart des organisations ne les ont jamais comptées, parce que leur observabilité a été construite autour du succès de la tâche et jamais autour de la classe d'étape.
À mettre en route cette semaine
Prélevez une semaine de traces d'agent en production et classez chaque étape en trois catégories : planification, exécution, jugement. Comptez les appels et les tokens par catégorie, pas par tâche. Tant que cette répartition n'est pas connue, toute discussion sur le routage porte sur des hypothèses.
Calculez la formule de décharge minimale avec vos propres prix, en incluant le coût du modèle juge que vous envisagez. Si le résultat dépasse ce que votre trafic peut réalistement décharger, la décision est prise et vous avez économisé un trimestre de travail d'intégration.
Écrivez un seuil de bascule par classe d'étape plutôt qu'une règle globale. Une validation de sortie d'outil et une décision de planification n'appellent pas la même exigence de justesse, et un seuil unique fait porter au tout la contrainte du cas le plus dur.
Constituez un jeu d'évaluation de trajectoire avant de basculer quoi que ce soit, et faites-en le garde-fou de la bascule. C'est le même dispositif que celui décrit dans l'article du 5 juillet sur le harnais, appliqué ici comme condition d'acceptation plutôt que comme outil de diagnostic.
Vérifiez enfin la réversibilité de ce que vous mettez en place. Une couche de routage qui ne sait pas revenir en un réglage à un modèle unique reproduit exactement la dépendance décrite dans l'article du 25 juillet sur la feuille de route multi-modèle, avec une pièce d'infrastructure de plus à maintenir.
Conclusion
La question posée à une direction technique cette semaine n'est pas de savoir si un modèle ouvert à 3 milliards de paramètres actifs peut remplacer un modèle frontière, la réponse dépend trop de la charge pour être générale. Elle est de savoir quelle proportion des étapes de vos trajectoires en production relève d'un travail d'exécutant, et pourquoi ces étapes tournent aujourd'hui sur votre modèle le plus cher sans que personne n'ait jamais eu à justifier ce choix. Les chiffres publiés ce mois-ci ne tranchent pas votre cas, ils rendent la question mesurable, et c'est déjà plus que ce dont disposaient la plupart des équipes il y a un mois.
Sources : As of August 2026
- [Primary] NVIDIA Nemotron 3.5 Lightning Delivers Fast, Accurate Specialized Task Execution for Long-Running Agents — Chris Alexiuk et Chintan Patel, NVIDIA — 11 août 2026 — https://developer.nvidia.com/blog/nvidia-nemotron-3-5-lightning-delivers-fast-accurate-specialized-task-execution-for-long-running-agents/
- [Primary] Route AI Agent Workloads Across Models with NVIDIA NeMo Switchyard — Tanay Varshney et al., NVIDIA — 11 août 2026 — https://developer.nvidia.com/blog/route-ai-agent-workloads-across-models-with-nvidia-nemo-switchyard/
- [Primary] How many of your agent's calls actually need a frontier model? — Srimanth Tangedipalli et Karan Singh, LangChain — 11 août 2026 — https://www.langchain.com/blog/switchyard-agent-routing-benchmark
- [Primary] Putting NVIDIA Nemotron 3.5 Lightning to the test — Gustavo Lujan, Allen Roush et Andy Nolan, Thoughtworks — 11 août 2026 — https://www.thoughtworks.com/insights/blog/generative-ai/putting-nvidia-nemotron-3-5-lightning-test
- [Primary] NVIDIA-Nemotron-3.5-Lightning-30B-A3B-BF16, fiche modèle — NVIDIA, Hugging Face — août 2026 — https://huggingface.co/nvidia/NVIDIA-Nemotron-3.5-Lightning-30B-A3B-BF16
- [Secondary] Nvidia's Switchyard router reshuffles AI models mid-task, cutting task costs to a third in its own tests — Sean Michael Kerner, VentureBeat — 11 août 2026 — https://venturebeat.com/orchestration/nvidias-switchyard-router-reshuffles-ai-models-mid-task-cutting-task-costs-to-a-third-in-its-own-tests
Comments ()