GKE Hypercluster, Predictive Latency Boost, KV Cache tiering : GKE devient une plateforme RL-first
Tout le monde regarde les modèles. Pendant ce temps, Google reconstruit silencieusement la couche qui les fait tourner.
Cloud Next 2026 a livré 10 annonces GKE en l'espace de deux heures de keynote. Prises isolément, chacune ressemble à une amélioration incrémentale. Prises ensemble, elles dessinent quelque chose de beaucoup plus structurant : GKE comme système d'exploitation de facto pour le reinforcement learning à l'échelle industrielle.
Si vous êtes Platform Engineer ou CTO en train d'arbitrer entre Kubernetes managé et une stack souveraine, ce post est pour vous.
Le problème que personne ne formule clairement
Le reinforcement learning at scale a trois ennemis structurels que le Kubernetes vanilla ne résout pas :
1. L'effet straggler. Dans un job RL distribué, le batch entier attend le worker le plus lent. Résultat : vos GPU à 4 € l'heure tournent à 30 % d'utilisation pendant que vous attendez un nœud lent.
2. Le goulot du long-context. Les modèles long-context (128k tokens et au-delà) créent des KV Caches massifs qui ne tiennent plus en RAM. Sans tiering intelligent, soit vous limitez le context, soit vous achetez 10x plus de mémoire.
3. La latence de provisionnement. Un RL Sandbox qui prend 3 minutes à démarrer pour exécuter un reward eval de 2 secondes : c'est une absurdité économique qui se répète des milliers de fois par run.
Les 10 annonces GKE répondent exactement à ces trois problèmes.
Les 10 annonces, organisées par couche
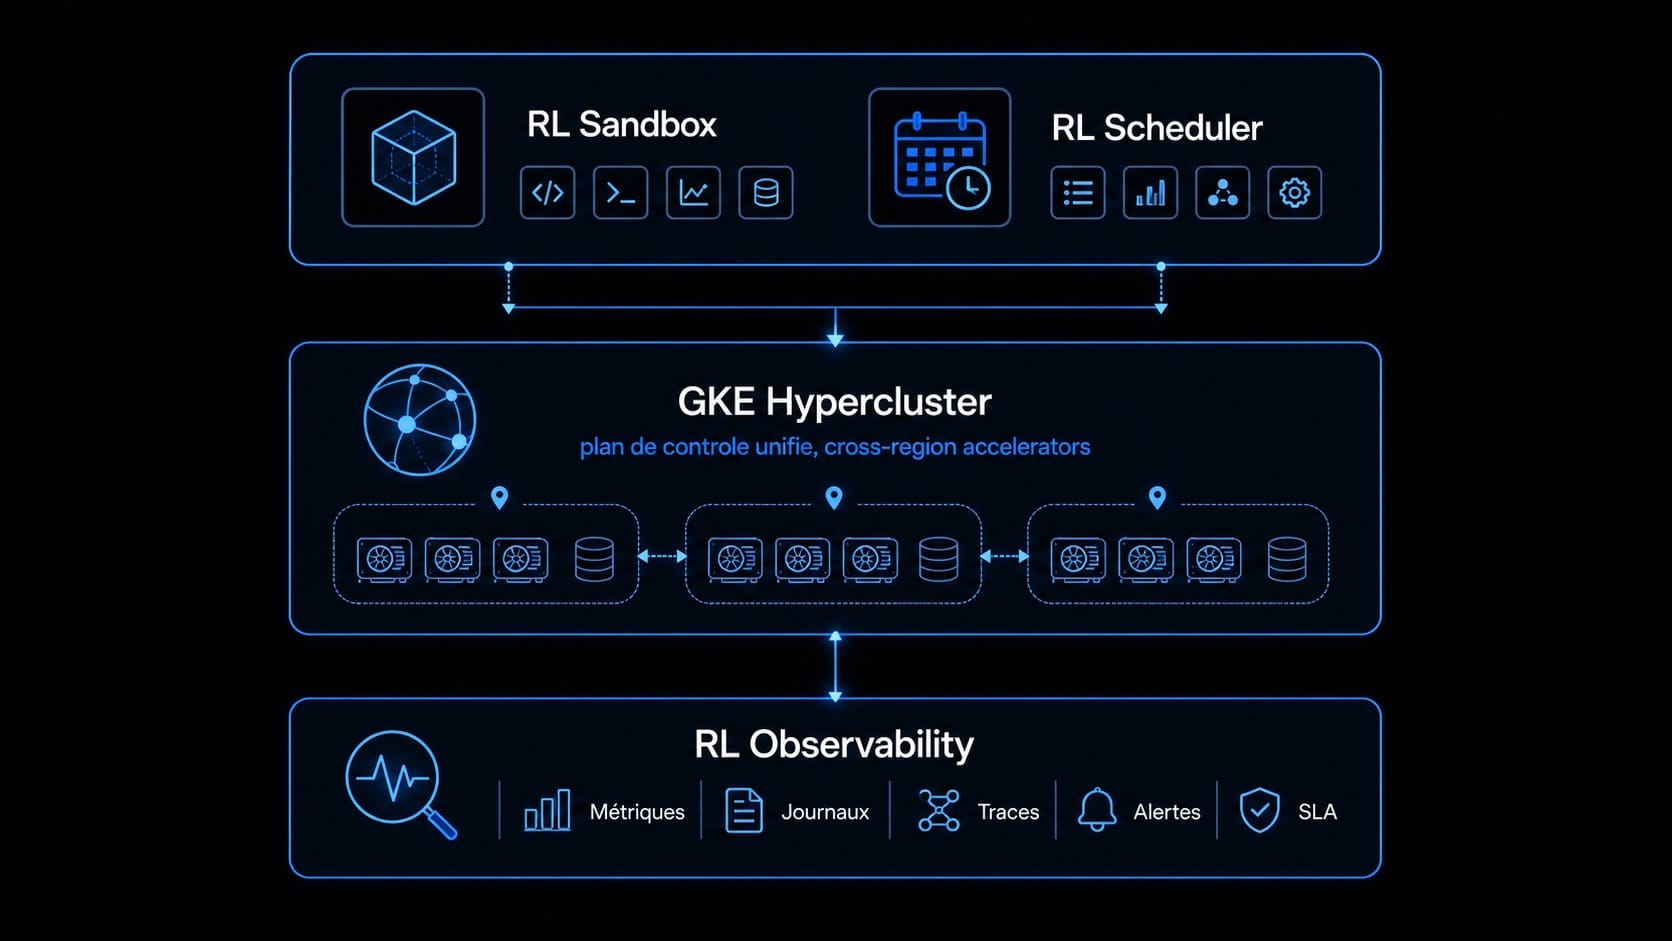
Couche 1 — Infrastructure RL (annonces 123, 126, 127, 128)
GKE Hypercluster (123) — Private GA Un plan de contrôle unique pour orchestrer des millions d'accélérateurs cross-region. Ce n'est plus "un cluster Kubernetes". C'est un fabric compute unifié. L'implication directe pour les équipes platform : vous n'avez plus à gérer la fragmentation multi-cluster avec des outils tiers. Le control plane devient le point d'intégration unique.
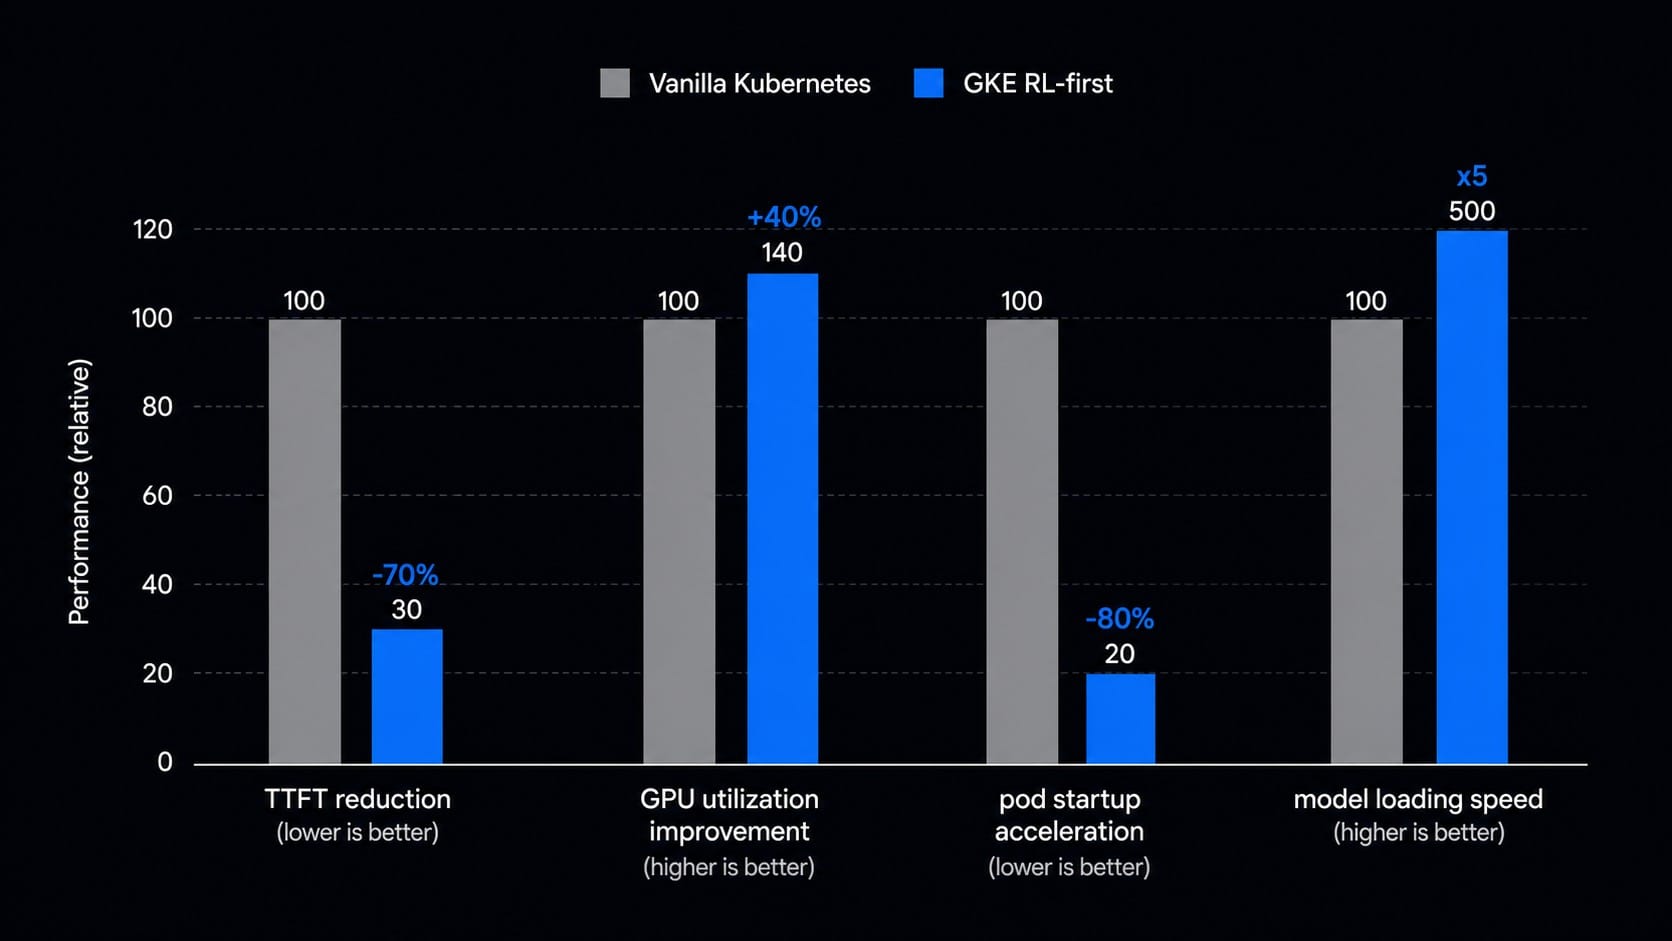
RL Scheduler (126) — Annoncé Résout l'effet straggler via un routing intelligent inter-batch. Le scheduler analyse les capacités temps réel et réaffecte les workloads avant que le straggler ne bloque l'ensemble. Sur les benchmarks internes Google, le gain d'utilisation GPU dépasse 40 % sur les jobs RL intensifs.
RL Sandbox (127) — Annoncé Isolation kernel-level pour tool-calling et reward evaluation, avec un provisionnement en millisecondes. C'est l'annonce la plus sous-estimée du lot. Aujourd'hui, dans les organisations que j'accompagne, l'isolation des reward evals est souvent bidouillée avec des namespaces Kubernetes ou des VM légères. Le résultat : soit des problèmes de sécurité, soit des latences rédhibitoires. RL Sandbox adresse les deux simultanément.
RL Observability + Reliability (128) — Annoncé Dashboards out-of-box pour debugger et optimiser la boucle RL entière. Ce n'est pas anecdotique : l'observabilité RL est aujourd'hui l'angle mort des stacks cloud. Les équipes instrumentent manuellement avec des patchworks Prometheus/Grafana qui ne comprennent pas la sémantique RL (reward convergence, policy update frequency, KL divergence). GKE le fait nativement.
Couche 2 — Performance inference (annonces 124, 125, 131)
Predictive Latency Boost (124) — Preview Réduit le Time-to-First-Token (TTFT) de 70 % via un routing capacity-aware en temps réel. Le mécanisme : au lieu de router vers le nœud "disponible", GKE prédit la latence effective de chaque nœud en fonction de sa charge actuelle et redirige vers le nœud optimal. Pour les applications conversationnelles ou les agents temps réel, 70 % de réduction TTFT n'est pas une métrique — c'est la différence entre un produit utilisable et un produit frustrant.
Auto KV Cache Storage Tiering (125) — Annoncé RAM + Local SSD + GCS/Lustre en tiering automatique pour les KV Caches long-context. La gestion du KV Cache est le problème #1 de coût pour les équipes qui déploient des modèles 70B+ avec des fenêtres de contexte étendues. Sans tiering, le choix est brutal : limiter le context ou sur-provisionner massivement en mémoire haute. Le tiering automatique supprime ce dilemme. Coût estimé vs RAM-only : division par 3 à 5 selon le profil d'usage.
Rapid Model Loading on GKE (131) — Disponible ×5 plus rapide via run:AI Streamer et Rapid Cache. Le chargement des modèles (notamment les LLMs 70B+) est souvent le goulot invisible : 8 à 15 minutes pour monter un pod de serving. Avec ×5, vous passez sous les 3 minutes. Sur des déploiements rolling ou des autoscaling events fréquents, l'impact sur le coût total d'infrastructure est significatif.
Couche 3 — Opérations quotidiennes (annonces 122, 129, 130)
GKE Agent Sandbox (122) — Disponible Add-on pour workloads isolés stateful single-replica optimisés agent. C'est la réponse GKE aux patterns d'agents autonomes : chaque agent tourne dans son propre sandbox isolé, avec un état persistant mais une surface d'attaque minimale. Utile dès que vous déployez des agents à longue durée de vie qui accumulent du contexte.
Scaling on Custom Metrics (129) — Disponible Autoscaling intent-based au-delà du CPU/mémoire. La bonne nouvelle : vous pouvez maintenant scaler sur n'importe quelle métrique métier (nombre de requêtes en queue, latence p95, backlog de jobs RL). La mauvaise nouvelle : cela demande une instrumentation correcte. Si vos applications n'exposent pas de métriques custom propres, cette feature ne vous aidera pas.
Accelerated Node + Pod Startup (130) — Disponible ×4 plus rapide pour les nœuds, -80 % pour les pods. Des chiffres importants pour les équipes qui font du scale-to-zero aggressif ou des workloads à burst court. En pratique, cela rend viables des patterns d'autoscaling qui n'étaient auparavant pas économiques à cause des temps de warm-up.
GKE vs vanilla Kubernetes : l'arbitrage honnête
La question que tout Platform Engineer pose : "Est-ce que je peux répliquer ça sur ma propre infra Kubernetes ?"
Ce que vous pouvez répliquer :
- Scaling on custom metrics : KEDA le fait depuis longtemps
- Observabilité de base : Prometheus + Grafana + des dashboards custom
- Model loading accéléré : avec les bonnes optimisations de stockage distribué
Ce que vous ne pouvez pas répliquer facilement :
- GKE Hypercluster : la gestion d'un control plane unifié pour des millions d'accélérateurs cross-region est un problème d'ingénierie de plateforme à plusieurs années-ingénieur
- RL Scheduler avec routing intelligent : le scheduler Kubernetes vanilla n'a pas la sémantique RL
- KV Cache tiering automatique : vous pouvez le construire, mais c'est 6 à 18 mois de travail spécialisé
- Predictive Latency Boost : le modèle prédictif de capacité en temps réel est une IP Google
Mon take : Pour une équipe de moins de 20 ingénieurs platform, la stack GKE managée est économiquement rationnelle dès lors que vous avez des workloads RL ou de serving LLM significatifs. Pour une organisation qui a déjà investi massivement dans une expertise Kubernetes souveraine, l'arbitrage est moins clair — mais les annonces 123, 124, 125 et 126 méritent une analyse sérieuse.
Ce que ça change pour les Platform Engineers
Trois implications concrètes :
1. Le RL devient un workload first-class sur Kubernetes. Ce n'est plus un hack. GKE fournit la sémantique, le scheduling, l'isolation et l'observabilité. Les équipes qui attendent "que le tooling RL mûrisse" n'ont plus d'excuse.
2. Le coût du long-context tombe d'un ordre de grandeur. Le KV Cache tiering automatique, combiné au rapid model loading, change les calculs économiques des déploiements 128k+ tokens. Recalculez votre TCO.
3. L'observabilité RL intégrée va créer une asymétrie de vitesse. Les équipes qui utilisent les dashboards out-of-box GKE vont itérer plus vite que celles qui construisent leur propre instrumentation. Ce n'est pas spectaculaire — mais sur 12 mois, c'est une divergence compétitive réelle.
Prochaine action recommandée
Si vous gérez une infrastructure d'inférence ou d'entraînement sur Kubernetes, prenez 30 minutes cette semaine pour modéliser l'impact des annonces 124 et 125 sur votre TCO actuel. Les chiffres parlent souvent d'eux-mêmes.
Vous voulez un deep dive régulier sur les annonces Cloud qui changent vraiment l'infrastructure IA ? Rejoignez la newsletter Think with Godwin — analyses techniques, sans bullshit, deux fois par semaine.
Annonces couvertes : #122 GKE Agent Sandbox, #123 GKE Hypercluster, #124 Predictive Latency Boost, #125 Auto KV Cache Storage Tiering, #126 RL Scheduler, #127 RL Sandbox, #128 RL Observability + Reliability, #129 Scaling on Custom Metrics, #130 Accelerated Node + Pod Startup, #131 Rapid Model Loading on GKE
Tags : #GKE #Kubernetes #RLOps
Comments ()