L'inventaire que personne n'a fait : combien d'agents IA tournent réellement dans votre organisation
Gartner a publié le 28 avril 2026 une note consacrée à la prolifération des agents, dont la projection centrale a beaucoup circulé : d'ici 2028, une entreprise du Fortune 500 mondial utiliserait en moyenne plus de 150 000 agents IA, contre moins de quinze en 2025. Le cabinet ajoute que seules 13 % des organisations estiment disposer de la gouvernance adaptée. Une prévision distincte, publiée en novembre 2025, avance que d'ici 2030 plus de 40 % des entreprises connaîtront un incident de sécurité ou de conformité lié à un usage non autorisé de l'IA.
Une projection à quatre ans avec un facteur dix mille mérite d'être maniée comme ce qu'elle est, une extrapolation de cabinet et non une mesure. Les données d'enquête disponibles sont plus modestes et plus utiles. Une étude publiée le 4 février 2026 auprès de plus de 900 dirigeants et praticiens techniques aux États-Unis et au Royaume-Uni rapporte que 80,9 % des équipes techniques ont dépassé la phase de planification, mais que 14,4 % seulement déclarent que la totalité de leurs agents sont passés en production avec une validation complète des équipes de sécurité. En moyenne, 47,1 % des agents d'une organisation font l'objet d'une surveillance ou d'une protection active. Autrement dit, plus de la moitié fonctionnent sans supervision ni journalisation.
La lecture courante de ces chiffres est celle d'un défaut de surveillance, qui appellerait un outil de surveillance. Les mêmes données disent autre chose, et le détail est décisif : 45,6 % des équipes utilisent encore des clés d'API partagées pour l'authentification entre agents, et 21,9 % seulement traitent leurs agents comme des entités porteuses d'une identité propre. Un agent sans identité distincte n'est pas un agent mal surveillé, c'est un agent qu'aucune surveillance ne peut désigner. Vous ne pouvez pas recenser une population dont les membres n'existent pas comme individus dans vos systèmes.
L'article du 23 juillet sur la gouvernance du risque agentique proposait une grille pour évaluer un agent avant son déploiement. Elle suppose résolu le problème traité ici, qui vient avant : disposer de la liste. Ce qui suit détaille pourquoi cette liste n'existe pas, pourquoi elle se périme, et comment la constituer.
L'inventaire est un problème d'identité, pas de découverte
L'ordre des causes compte, parce qu'il détermine où intervenir. Une organisation ne perd pas la trace de ses agents parce qu'elle a négligé de les inscrire quelque part. Elle la perd parce que la décision technique qui rendait le recensement possible a été prise des mois plus tôt, par un développeur qui a réutilisé une clé existante plutôt que d'en créer une, pour une raison parfaitement banale de délai.
À partir de là, l'enchaînement est mécanique. Plusieurs agents parlent avec le même identifiant, donc les journaux du fournisseur en aval montrent un seul appelant. Un incident survient, l'équipe de sécurité remonte la piste jusqu'à un compte de service partagé, et s'arrête là. La question de savoir quel agent a agi n'a pas de réponse technique, quel que soit l'outil déployé après coup. C'est le prolongement direct du principe de moindre privilège discuté dans l'article du 13 juillet sur le contrôle d'accès des agents : un privilège ne peut être restreint que s'il est attribué à quelqu'un.
Un chiffre de la même enquête ajoute une difficulté d'un autre ordre. Un quart environ des agents déployés peuvent créer et mandater un autre agent. La population n'est donc pas seulement sous-estimée, elle est auto-génératrice. Un inventaire pris aujourd'hui a une durée de validité, et cette durée n'est pas déterminée par le rythme de vos projets mais par celui des agents eux-mêmes. Un registre alimenté manuellement, à la demande, sera faux avant d'être terminé.
Il faut ajouter la réserve d'usage sur ces données : l'enquête citée émane d'un éditeur qui vend précisément de la gestion d'identité et de la gouvernance d'agents. Cela n'invalide pas des pourcentages déclaratifs collectés auprès de 900 répondants, mais impose de ne pas les traiter comme une mesure indépendante. Ce qui est solide dans ces chiffres, c'est l'écart entre la perception et la pratique déclarée par les mêmes personnes : 82 % des dirigeants interrogés se disent confiants dans la capacité de leurs politiques existantes à prévenir les actions non autorisées d'un agent, quand 88 % des organisations rapportent un incident avéré ou suspecté sur l'année écoulée. Ces deux réponses viennent du même échantillon, ce qui les rend comparables entre elles indépendamment de qui a commandé l'étude.
Où se cachent les agents que vous ne comptez pas
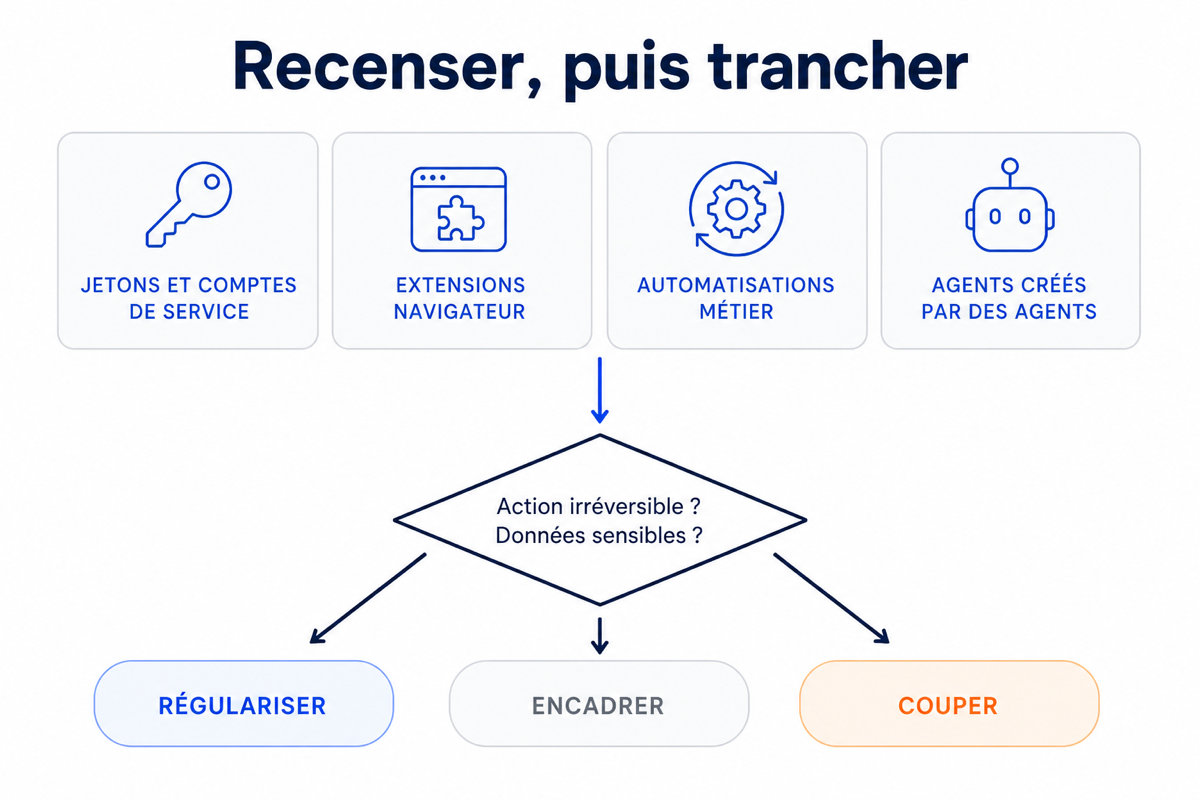
Le recensement échoue quand il part du registre plutôt que du terrain. Quatre gisements concentrent l'essentiel de ce qui manque, et aucun ne se trouve dans un catalogue applicatif.
Les intégrations d'API et les comptes de service. Passez en revue les jetons actifs sur vos fournisseurs de modèles et sur vos systèmes internes, en regardant la date de dernier usage plutôt que la date de création. Un jeton actif dont aucun propriétaire ne peut être nommé désigne soit un agent oublié, soit un agent que quelqu'un préfère ne pas déclarer.
Les extensions et agents de navigateur, qui échappent aux revues d'architecture parce qu'ils s'installent côté poste de travail et n'apparaissent dans aucun contrat. Les remontées de votre navigateur géré en donnent la liste en quelques minutes, à condition que quelqu'un pense à la demander.
Les automatisations construites dans les plateformes métier, où un flux comportant un appel de modèle est un agent au sens du risque même s'il ne porte pas ce nom dans l'outil. C'est le gisement le plus large et le moins exploré, parce qu'il relève d'équipes qui ne se considèrent pas comme des équipes techniques.
Les agents créés par d'autres agents, enfin, qui ne peuvent être découverts que par observation du trafic. C'est le seul des quatre gisements qui exige une détection continue plutôt qu'un scan ponctuel.
Régulariser, encadrer, ou couper
Un inventaire sans règle de décision produit une liste que personne ne traite. Le tri le plus simple qui fonctionne repose sur deux questions posées à chaque agent découvert, et il donne trois issues.
La première question porte sur l'irréversibilité : cet agent peut-il écrire, envoyer, payer ou supprimer, ou se contente-t-il de lire et de proposer ? La seconde porte sur l'exposition : touche-t-il à des données personnelles, financières ou réglementées ?
Un agent en lecture seule sur des données non sensibles se régularise, c'est-à-dire qu'on lui attribue une identité propre, un propriétaire nommé et une entrée au registre, sans interrompre son fonctionnement. Un agent qui coche une seule des deux cases s'encadre : identité propre, périmètre restreint, journalisation distincte, et revue à date fixe. Un agent qui coche les deux et n'a jamais été validé se coupe immédiatement, avant discussion. Cette dernière règle est celle qui suscite le plus de résistance et c'est la seule qui produit un effet sur le comportement, parce qu'elle rend le coût du contournement supérieur au coût de la déclaration.
Le schéma qui revient dans les organisations qui reprennent la main est d'ailleurs celui-là. Elles ne cherchent pas à interdire, ce qui produit mécaniquement plus d'agents non déclarés, mais à rendre la voie déclarée plus rapide que la voie sauvage. Quand obtenir une identité d'agent prend une heure et une clé partagée en prend zéro, le résultat est connu d'avance. Quand cela prend cinq minutes en libre-service, le problème disparaît sans qu'aucune politique n'ait eu à être appliquée.
À mettre en route cette semaine
Comptez ce que vous croyez avoir, puis comptez ce que vous avez. Demandez à chaque responsable d'équipe le nombre d'agents en fonctionnement dans son périmètre, puis extrayez la liste des jetons actifs sur vos fournisseurs de modèles. L'écart entre les deux chiffres est votre point de départ, et il est plus parlant que n'importe quelle statistique de cabinet.
Relevez la proportion de vos agents qui partagent un identifiant avec un autre. C'est la mesure qui détermine si un inventaire est même techniquement possible chez vous, et elle passe avant tout achat d'outil.
Créez le registre avec quatre colonnes seulement : identifiant de l'agent, propriétaire nommé, périmètre d'action, date de dernière revue. Un registre à vingt colonnes ne sera pas rempli, un registre à quatre le sera.
Rendez l'obtention d'une identité d'agent plus rapide que la réutilisation d'une clé existante. C'est une décision de plateforme, pas de sécurité, et c'est le seul levier qui agit sur la cause plutôt que sur les symptômes.
Fixez enfin la règle de coupure immédiate, écrite et validée en comité : quel type d'agent non déclaré est arrêté sans discussion préalable. Une règle qui n'a jamais été appliquée une fois ne sera jamais crue.
Conclusion
La prévision des 150 000 agents se vérifiera ou non, et cela n'a pas grande importance pour la décision à prendre. Ce qui compte est que l'ordre des opérations est aujourd'hui inversé dans la plupart des organisations : on y débat de cadres de gouvernance applicables à une population que personne n'est capable d'énumérer, avec des outils de surveillance qui observeront des acteurs dépourvus de nom. Le premier livrable n'est pas une politique, c'est une liste, et la condition pour l'obtenir est que chaque agent cesse d'emprunter l'identité d'un autre.
Sources : As of July 2026
- [Primary] Gartner Identifies Six Steps to Manage Artificial Intelligence Agent Sprawl — Gartner — 28 avril 2026 — https://www.gartner.com/en/newsroom/press-releases/2026-04-28-gartner-identifies-six-steps-to-manage-artificial-intelligence-agent-sprawl
- [Primary] Gartner Identifies Critical GenAI Blind Spots That CIOs Must Urgently Address — Gartner — 19 novembre 2025 — https://www.gartner.com/en/newsroom/press-releases/2025-11-19-gartner-identifies-critical-genai-blind-spots-that-cios-must-urgently-address0
- [Primary] State of AI Agent Security 2026 Report: When Adoption Outpaces Control — Jorge Ruiz, Gravitee — 4 février 2026 — https://www.gravitee.io/blog/state-of-ai-agent-security-2026-report-when-adoption-outpaces-control
- [Primary] The State of AI Agent Security 2026 (rapport complet) — Gravitee — février 2026 — https://www.gravitee.io/state-of-ai-agent-security
- [Secondary] AI agent sprawl: what it is and how to control it — IBM Think — 2026 — https://www.ibm.com/think/topics/ai-agent-sprawl
- [Secondary] Gartner: 40% of Firms to Be Hit By Shadow AI Security Incidents — Infosecurity Magazine — 2025 — https://www.infosecurity-magazine.com/news/gartner-40-firms-hit-shadow-ai/
- [Secondary] Gartner says 40% of enterprises will experience 'shadow AI' breaches by 2030 — IT Pro — 2025 — https://www.itpro.com/technology/artificial-intelligence/gartner-says-40-percent-of-enterprises-will-experience-shadow-ai-breaches-by-2030-educating-staff-is-the-key-to-avoiding-disaster
Comments ()