Moderniser du code legacy avec des agents : traduire le code est la partie facile
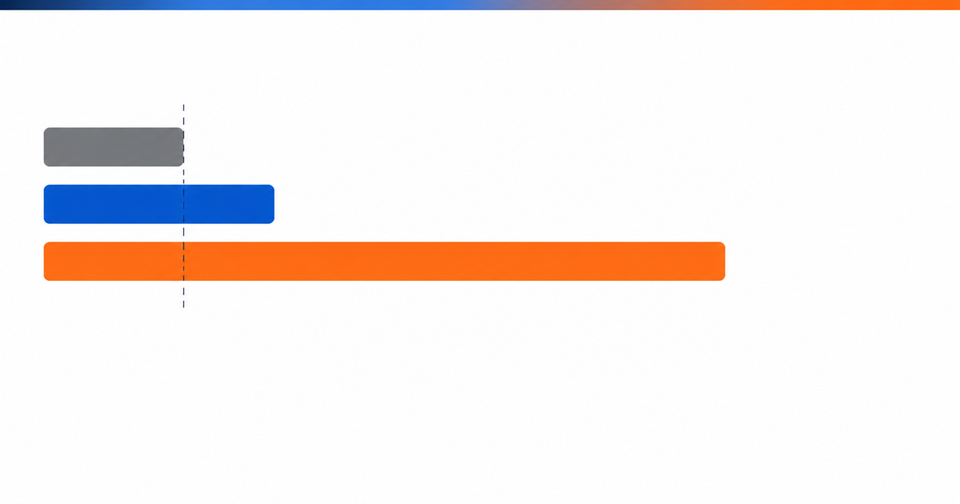
IBM a annoncé le 9 juillet 2026 des capacités multi-agents et des workflows spécialisés de modernisation pour sa plateforme de développement agentique, avec des paquets dédiés à IBM Z, IBM i et à la migration Java. L'offre destinée au mainframe raisonne à travers COBOL, PL/I, assembleur, JCL, CICS, IMS et Db2, et inclut une extraction de règles métier destinée à préserver la logique institutionnelle restée non documentée après des décennies de production. Le communiqué cite un client dont un chantier de modernisation initialement estimé à neuf mois pour quatorze ingénieurs aurait été bouclé en trois jours.
Ce type de chiffre appelle la prudence d'usage réservée à tout témoignage client publié par un fournisseur, mais l'ordre de grandeur n'est pas invraisemblable, et c'est précisément ce qui devrait inquiéter. Traduire du code n'est plus le goulot d'étranglement. Or la lenteur de la traduction jouait jusqu'ici un rôle de contrôle involontaire : réécrire à la main obligeait quelqu'un à comprendre ce que le code faisait. Ce garde-fou vient de disparaître, et le travail difficile, qui consiste à prouver que le nouveau système se comporte comme l'ancien, n'a pas accéléré du tout. Il a même empiré, puisqu'il doit maintenant absorber un volume de code transformé sans commune mesure avec ce qu'il traitait avant.
L'article du 29 juin sur le SDLC à l'ère agentique décrivait la restructuration de chaque phase du cycle de développement. La modernisation du legacy en est le cas extrême, parce qu'elle est la seule situation où la spécification n'existe nulle part ailleurs que dans le système en fonctionnement. Ce qui suit mesure l'ampleur réelle du risque, montre pourquoi la parade la plus intuitive ne marche pas, et propose quatre portes à franchir dans l'ordre.
Ce que mesure une étude qui a pris la peine de vérifier
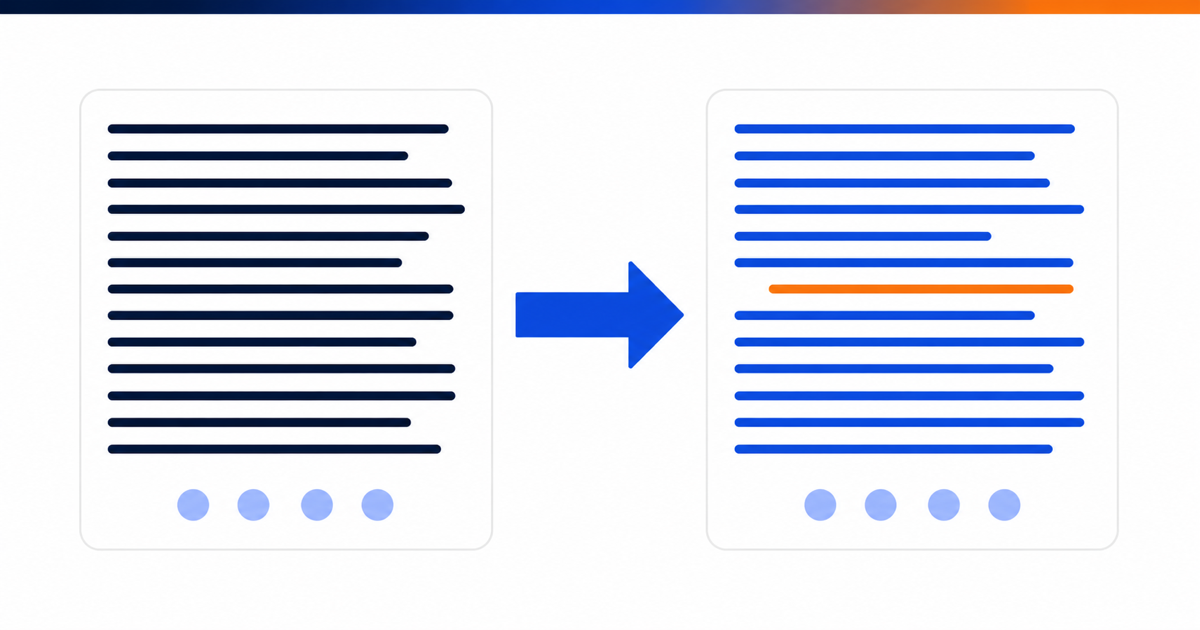
Un travail publié sur arXiv en mai 2026 par trois chercheurs pose la question dans les termes les plus simples : quand un modèle modernise du code, peut-on lui faire confiance pour reconnaître que sa propre sortie a silencieusement changé le comportement observable ? Le protocole comporte 1 980 appels de modernisation réels sur onze modèles de production issus de sept familles distinctes, appliqués à un corpus équilibré de soixante extraits de Python 2, avec trois formulations d'instruction différentes. Chaque sortie est évaluée par un oracle comportemental à typage strict, puis le modèle producteur est interrogé sur la préservation du comportement de son propre code.
Les taux de dérive se répartissent en trois niveaux nettement séparés. Sur les extraits témoins, qui ne nécessitent aucune modernisation réelle, le taux de dérive est de 7 %, ce qui donne le bruit de fond : même quand il n'y a rien à faire, les modèles cassent quelque chose une fois sur quatorze. Sur les pièges syntaxiques, dont l'équivalent moderne est univoque, la dérive monte à 12,7 %. Sur les pièges de préservation sémantique, elle atteint 39,7 %. La classe dominante est la sémantique numérique, à 57 % de dérive, très loin devant l'évaluation paresseuse à 21 %.
L'exemple canonique est instructif parce qu'il est trivial. En Python 2, la division de deux entiers renvoie un entier, 5 divisé par 2 valant 2. En Python 3, la même expression renvoie 2,5. Un code migré qui conserve l'opérateur produit donc un résultat différent, sans erreur, sans exception, avec une valeur parfaitement plausible. Les auteurs insistent sur un point de méthode qui devrait figurer dans toute stratégie de test : en comparant les résultats avec une égalité permissive plutôt qu'un typage strict, le taux de dérive mesuré tombe de 39,7 % à environ 26,7 %, parce que 2 et 2,0 sont considérés comme égaux. Treize points de dérive disparaissent dans la comparaison, pas dans le code. Un consommateur en aval qui utilise cette valeur comme index de liste, qui la sérialise ou qui teste son type, lui, verra la différence.
Deux autres résultats méritent d'être retenus par quiconque construit une stratégie de sélection d'outils. D'abord, la dérive est structurelle et non aléatoire : la corrélation entre modèles sur la difficulté des extraits atteint 0,52 en moyenne, et un noyau d'extraits résiste à au moins huit modèles sur onze quelle que soit l'instruction. Ensuite, et c'est le plus dérangeant pour un comité d'achat, le taux de dérive ne suit ni la capacité ni le prix. Il s'étale de 5,6 % à 46,7 % selon les modèles, sur un panel dont les tarifs varient d'un facteur deux cents, et le modèle le moins cher du lot obtient le meilleur résultat. Les auteurs en tirent la conclusion qui s'impose : une règle de sélection fondée sur le fournisseur ou sur la taille du modèle ne protège pas de cette classe de dérive, un oracle comportemental explicite est nécessaire.
L'auto-relecture n'est pas un filet de sécurité
La parade la plus naturelle, et de loin la moins chère, consiste à demander au modèle de vérifier son propre travail. C'est exactement ce que l'étude teste, sur les 262 cas où l'oracle a détecté une dérive sémantique avérée.
Le résultat agrégé pourrait sembler acceptable : l'auto-relecture attrape environ deux tiers des dérives. Le tiers restant est le problème, parce qu'il ne s'agit pas d'un simple défaut de couverture mais d'une validation explicite. Sur 262 cas, 83 sont silencieusement approuvés par le modèle qui les a produits, soit 31,7 %. Sur la classe la plus fréquente, la sémantique numérique, 75 dérives sur 207 passent la relecture, soit 36 %.
Le comportement par modèle est fortement bimodal, et c'est ce qui rend la parade inutilisable en l'état. Cinq modèles ne manquent pratiquement aucune de leurs propres dérives. Un modèle largement déployé en manque la totalité. Surtout, ce taux d'auto-aveuglement n'est pas prédit par le taux de dérive : le modèle qui dérive le plus, à 65 %, détecte 100 % de ses propres erreurs, tandis qu'un modèle qui dérive modérément, à 41,7 %, en valide 100 %. La fiabilité de l'auto-relecture est donc une propriété du modèle orthogonale à sa justesse, ce qui signifie qu'aucun classement de performance ne vous dit à qui vous pouvez confier la vérification.
Le détail qualitatif rapporté par les auteurs est celui qu'il faut avoir en tête au moment d'arbitrer. Sur plusieurs cas, le modèle ouvre son auto-évaluation en énonçant correctement la différence entre Python 2 et Python 3 sur l'opérateur de division, puis conclut que le comportement est préservé. Il décrit le mécanisme exact qui a cassé sa propre sortie, et déclare la sortie intacte.
Un dernier résultat mérite d'être signalé parce qu'il contredit une pratique répandue. Les trois formulations d'instruction testées ne produisent pas le même taux de dérive, et c'est la plus soignée qui obtient le pire résultat : l'instruction cadrée comme un contrat de production, nommant les appelants en aval, atteint environ 32 % de dérive contre 19 % pour l'instruction directe. Les auteurs suggèrent que le modèle produit alors des réécritures plus élaborées, jugées plus sûres, et sémantiquement différentes. Insister sur l'enjeu dans le prompt ne réduit pas le risque, cela le déplace.
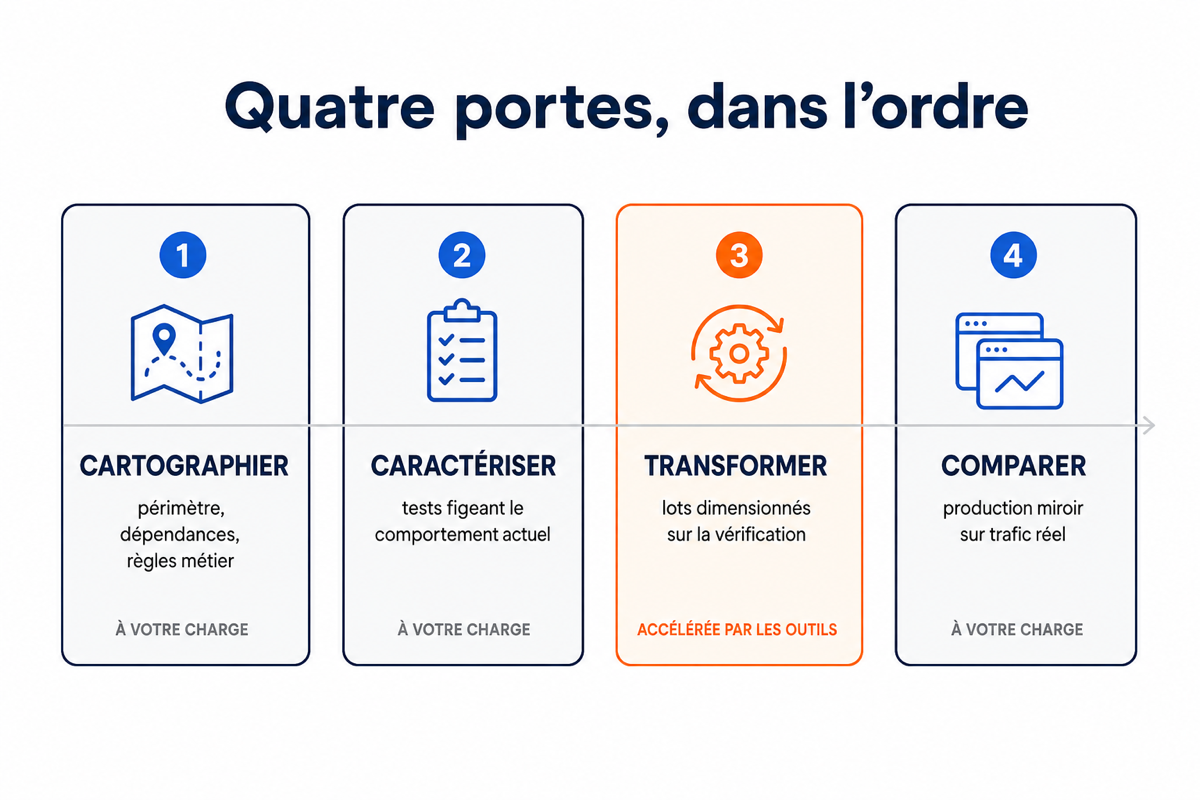
Quatre portes, et une seule que les outils franchissent pour vous
La conséquence est un ordre d'exécution, et c'est le renversement de celui que la plupart des programmes suivent.
Première porte, cartographier. Établissez le périmètre réel : points d'entrée, dépendances, jeux de données, traitements par lots, et surtout les règles métier qui ne vivent que dans le code. C'est le seul endroit où l'extraction assistée par agent, telle que la proposent aujourd'hui les paquets spécialisés du marché, apporte une valeur nette et peu risquée, puisqu'elle produit de la documentation soumise à relecture humaine et non du code exécutable.
Deuxième porte, caractériser par des tests. Avant la première ligne modifiée, construisez une suite qui fige le comportement actuel, correct ou non. C'est le point où les agents servent le mieux, et il est massivement sous-exploité : générer des tests à partir des entrées et des sorties observées d'un système en fonctionnement est une tâche que les modèles font bien, à faible risque, et qui produit exactement l'oracle dont l'étude ci-dessus démontre la nécessité. La règle qui découle des données est simple : votre oracle doit comparer le type autant que la valeur, faute de quoi il masquera la classe de dérive la plus fréquente.
Troisième porte, transformer par lots. C'est la seule des quatre que les outils accélèrent réellement, et il faut en profiter, à condition de dimensionner les lots sur la capacité de vérification et non sur la capacité de génération. Un lot dont la dérive éventuelle n'est pas détectable avant la mise en production est trop gros, quel que soit le temps qu'il a coûté à produire.
Quatrième porte, comparer en production miroir. Faites tourner l'ancien et le nouveau système en parallèle sur du trafic réel, en n'utilisant que les sorties de l'ancien, et comparez. C'est la seule méthode qui utilise le système existant comme oracle vivant plutôt que comme souvenir, et c'est ce que l'étude appelle en creux quand elle rappelle que l'équivalence comportementale est un critère plus exigeant que le passage des tests.
Le schéma qui revient dans les programmes qui aboutissent est d'ailleurs celui-là : ils dépensent la majorité de leur budget agentique sur les portes deux et quatre, pas sur la trois. Ceux qui échouent ont investi l'essentiel dans la génération, obtenu très vite un système entier réécrit, et découvert qu'ils n'avaient aucun moyen de savoir s'il était juste.
À mettre en route cette semaine
Vérifiez la comparaison de vos tests existants avant tout le reste. Si vos assertions comparent des valeurs sans comparer les types, vous avez déjà un oracle qui laisse passer la classe de dérive la plus courante, et ce défaut se corrige en quelques heures.
Prenez un module legacy représentatif et faites-en générer une suite de tests de caractérisation à partir du comportement observé, avant toute modification. Mesurez la couverture obtenue et le temps passé : c'est le chiffre qui doit dimensionner tout le reste du programme.
Interdisez par écrit l'auto-validation par le modèle producteur. Que la vérification passe par un oracle exécutable, un second modèle d'une autre famille, ou une relecture humaine, la règle est qu'elle ne peut pas venir de celui qui a écrit le code.
Constituez un corpus de pièges propre à votre patrimoine, sur le modèle de l'étude : une vingtaine de cas connus où la migration change le comportement de façon plausible. Faites-le tourner à chaque changement d'outil ou de modèle. Il vous coûtera une journée et vous servira des années.
Montez enfin une production miroir sur un périmètre restreint avant d'industrialiser. Le coût d'un double calcul sur du trafic réel est dérisoire comparé à celui d'une divergence métier découverte trois trimestres plus tard dans un rapprochement comptable.
Conclusion
L'arrivée d'agents capables de réécrire un patrimoine entier en quelques jours est une bonne nouvelle mal cadrée. Elle supprime la contrainte qui limitait ces programmes depuis vingt ans, et elle laisse intacte celle qui les fait échouer. La question à poser à un fournisseur n'est plus de savoir en combien de temps il traduit, question à laquelle tout le monde répond désormais la même chose, mais comment il prouve l'équivalence, et la seule réponse acceptable désigne quelque chose d'extérieur au modèle. Un système qui compile, passe les tests, tourne plus vite et calcule autre chose est un échec plus coûteux qu'un système qui ne démarre pas.
Sources : As of July 2026
- [Primary] Articulate but Wrong: Self-Review Failures in LLM-Based Code Modernization — Gokul Chandra Purnachandra Reddy, Aditya Lolla, Harsha Sanku (arXiv:2605.21537) — 20 mai 2026 — https://arxiv.org/abs/2605.21537
- [Primary] IBM Advances Enterprise AI Software Development with Multi-Agent Capabilities and Specialized Modernization Workflows — IBM — 9 juillet 2026 — https://newsroom.ibm.com/2026-07-09-ibm-advances-enterprise-ai-software-development-with-multi-agent-capabilities-and-specialized-modernization-workflows
- [Primary] Testing equivalences for processes — R. De Nicola et M. Hennessy, Theoretical Computer Science vol. 34 — 1984 — https://doi.org/10.1016/0304-3975(84)90113-0
- [Secondary] IBM Bob Gets Multi-Agent Muscle and a Cost Dashboard for Enterprise Coding — DevOps.com — juillet 2026 — https://devops.com/ibm-bob-gets-multi-agent-muscle-and-a-cost-dashboard-for-enterprise-coding/
- [Secondary] AI Agents Don't Modernize Legacy Code on Their Own — iSAQB — 2026 — https://www.isaqb.org/blog/ai-agents-dont-modernize-legacy-code-on-their-own/
- [Secondary] Architectural Testing Patterns for Agentic AI in Legacy Modernization — Adnan Masood — juin 2026 — https://medium.com/@adnanmasood/architectural-testing-patterns-for-agentic-sdlc-in-legacy-modernization-5e8ffa1e0299
Comments ()