Vos agents sont prêts, mais votre plateforme de données ne l'est pas
Google Cloud a publié le 23 juillet 2026 un billet dont le titre pose la question dans les bons termes : vos agents sont prêts, vos données le sont-elles ? Il s'appuie sur une enquête menée auprès de 1 402 responsables informatiques, dont le résultat le plus repris indique que 83 % des organisations estiment avoir besoin d'une mise à niveau d'infrastructure pour supporter des systèmes agentiques en production. Deux autres chiffres du même rapport sont plus instructifs : 43 % des répondants désignent la difficulté d'intégration avec les API et les sources de données existantes comme leur principal manque, et 81 % citent la complexité opérationnelle et la charge d'ingénierie parmi les dépenses imprévues au moment de passer à l'échelle.
La lecture spontanée d'un tel chiffre est budgétaire : il faudrait acheter de la capacité. Une donnée académique indépendante suggère que ce n'est presque jamais le problème. Sur Spider, le jeu d'évaluation historique de la génération de requêtes SQL à partir du langage naturel, les modèles de pointe atteignent environ 91 % de justesse. Sur Spider 2.0, qui reprend des schémas d'entreprise réalistes plutôt que des bases d'école, les mêmes modèles tombent entre 17 et 21 %. Aucun octet de mémoire supplémentaire ne comble un écart de soixante-dix points obtenu à modèle constant, avec la même compétence SQL, en changeant uniquement la nature des données. Ce que ces chiffres décrivent n'est pas un défaut de puissance, c'est un défaut de sens.
L'article du 2 août sur ce que révèlent les event logs posait un prérequis de processus avant de déployer des agents. Ce qui suit pose le prérequis de plateforme, qui se joue sur deux plans distincts et souvent confondus : la charge que l'agent fait subir aux systèmes, et le sens que ces systèmes sont capables de lui rendre.
Un agent n'est pas un chatbot, et la différence est mesurable
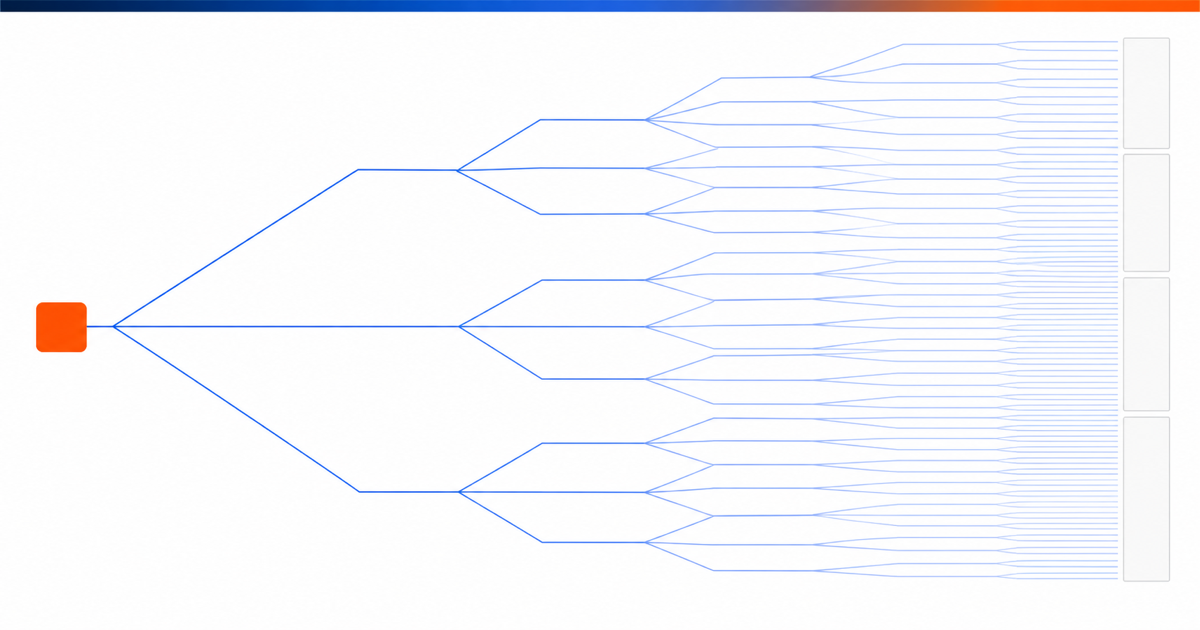
La description que donne Google Cloud du profil de charge est exacte et vaut d'être retenue : une seule invite peut déclencher un agent qui navigue, interroge et exécute de façon autonome à travers plusieurs systèmes. Un assistant conversationnel produit un appel et une réponse. Un agent produit une arborescence.
L'ordre de grandeur, lui, ne vient pas des éditeurs. Un benchmark publié sur arXiv en juillet 2026 sur des tâches longues en terminal mesure, sur quinze modèles de pointe, une moyenne de 9,9 millions de tokens par tâche, environ 231 épisodes et 85,3 minutes d'exécution par exécution. Ces valeurs concernent un contexte de développement plutôt qu'un entrepôt de données, et ne se transposent pas telles quelles. Mais elles donnent le facteur d'amplification que personne ne dimensionne : entre la demande formulée par un utilisateur et le travail réellement demandé aux systèmes sous-jacents, il y a deux ordres de grandeur.
Trois conséquences en découlent, et aucune ne se règle par de la capacité brute. La première est la concurrence : cent utilisateurs qui posent une question ne produisent pas cent requêtes, ils produisent des milliers d'appels simultanés qui se heurtent aux limitations de débit de vos API internes bien avant de saturer votre entrepôt. La deuxième est la latence composée : une étape à 400 millisecondes est excellente pour un tableau de bord et rédhibitoire au bout de deux cents itérations. La troisième est le droit d'écriture, que les architectures de lecture seule n'ont jamais eu à traiter et qui devient central dès que l'agent doit agir plutôt que répondre.
Le vrai manque est sémantique
Revenons à l'écart de soixante-dix points. Ce qui change entre les deux jeux d'évaluation, ce sont des tables nombreuses aux noms voisins, des colonnes dont l'intitulé ne dit pas la signification métier, des jointures qui supposent une convention interne, et des tables abandonnées que rien ne signale comme telles. Autrement dit, exactement votre entrepôt.
Les analyses de ces erreurs convergent sur un point : la très grande majorité des échecs de génération de requêtes ne viennent pas d'une syntaxe fautive mais d'une compréhension erronée du schéma ou du sens des données, c'est-à-dire d'une supposition sur ce que représente une colonne ou sur ce que signifie une jointure. Un agent qui écrit du SQL parfaitement valide sur la mauvaise table produit un chiffre faux, présenté avec assurance, et sans aucun signal d'erreur nulle part dans la chaîne.
La réponse technique qui émerge est la couche sémantique, c'est-à-dire un niveau intermédiaire qui expose des entités et des métriques définies plutôt que des tables brutes. Les mesures publiées sur ce point sont encourageantes et méritent une double réserve. Un banc d'essai publié en 2026 par dbt Labs rapporte, sur des questions de niveau comité de direction ou audit, un passage de 90,0 % à 98,2 % de justesse pour un modèle et de 84,1 % à 100 % pour un autre, en substituant l'accès par couche sémantique à la génération directe de SQL. Un travail académique publié sur arXiv en juin 2026 décrit un agent médié par une couche sémantique avec compilation SQL déterministe atteignant 94,15 % de justesse d'exécution sur les 547 tâches d'un banc dérivé de Spider 2.0. La première mesure vient d'un éditeur qui vend une couche sémantique, ce qui n'invalide pas le résultat mais impose de ne pas le citer seul ; la seconde, indépendante, va dans le même sens sur un périmètre plus étroit.
Le point exploitable pour un décideur n'est pas le pourcentage exact, il est structurel : la même architecture qui rend un agent fiable est celle qui rend le sens explicite, et cette architecture existait déjà comme bonne pratique de gouvernance des données bien avant les agents. Le schéma qui revient sur le terrain est que les équipes ayant investi dans un catalogue et des définitions de métriques partagées obtiennent des résultats immédiatement supérieurs, sans avoir rien changé au modèle. Celles qui ne l'ont pas fait interprètent ce même écart comme une insuffisance du modèle et changent de fournisseur, sans effet.
Six tests avant de passer à l'échelle
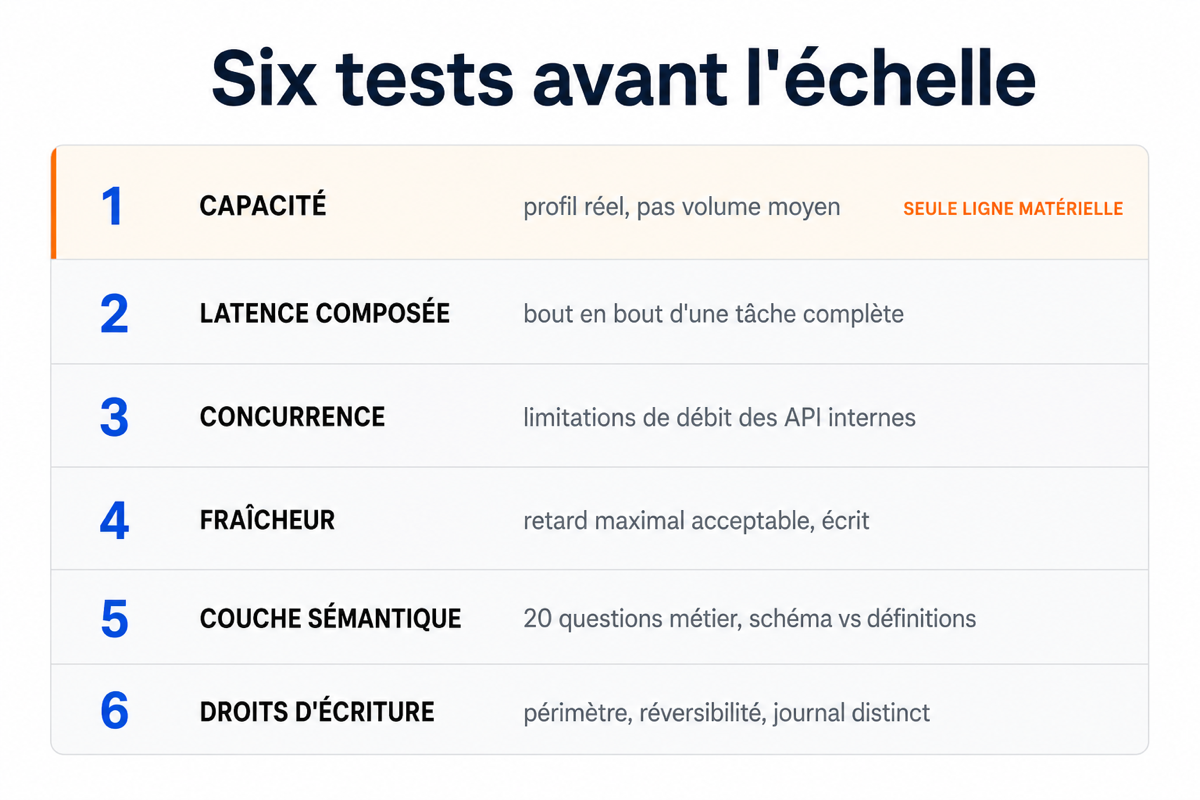
La conséquence pratique tient en un protocole d'essai, à exécuter avant l'ouverture aux utilisateurs et non après le premier incident.
La capacité, mesurée sur le profil réel plutôt que sur un volume moyen. Rejouez une journée de trafic prévu en respectant le facteur d'amplification, pas le nombre de demandes utilisateurs.
La latence composée. Chronométrez le bout en bout d'une tâche complète, pas le temps de réponse d'une requête. C'est le seul chiffre qui décide si l'usage sera adopté.
La concurrence, et en particulier les limitations de débit de vos propres API internes. Elles sont presque toujours le premier mur rencontré, et elles ne figurent dans aucun plan de capacité parce que personne ne les considère comme de l'infrastructure.
La fraîcheur des données. Un agent qui agit sur un état vieux de six heures produit des décisions justes sur un monde qui n'existe plus. Écrivez, par cas d'usage, le retard maximal acceptable, et vérifiez-le.
La couche sémantique. Prenez vingt questions métier réelles et comparez la justesse obtenue en accès direct au schéma et en accès par définitions. L'écart mesuré chez vous vaut mieux que n'importe quel banc d'essai publié.
Les droits d'écriture, enfin, avec la même exigence que celle posée dans l'article du 13 juillet sur le contrôle d'accès des agents : périmètre explicite, réversibilité, journalisation distincte de celle de l'utilisateur qui a formulé la demande.
À mettre en route cette semaine
Mesurez votre facteur d'amplification sur un cas d'usage existant. Instrumentez une tâche agentique de bout en bout et comptez les appels réellement émis par demande utilisateur. Ce chiffre unique change tous vos dimensionnements et personne dans l'équipe ne le connaît aujourd'hui.
Prenez vingt questions métier fréquentes et faites-les traiter par un agent en accès direct au schéma. Comptez les réponses justes. C'est votre référence, et elle sera probablement plus proche de vingt pour cent que de quatre-vingt-dix.
Documentez en priorité les dix tables les plus sollicitées, avec le sens métier de chaque colonne ambiguë et le marquage explicite des tables abandonnées. C'est l'intervention au meilleur rapport effet sur effort de toute cette liste.
Relevez les limitations de débit de vos API internes et confrontez-les au facteur d'amplification mesuré au premier point. La comparaison vous dira si votre passage à l'échelle est une question de budget ou de refonte.
Écrivez enfin le retard maximal acceptable par cas d'usage, en minutes, et faites-le valider par le métier plutôt que par l'équipe données. C'est une décision d'exposition au risque, pas une décision technique.
Conclusion
Il faut lire le rapport qui ouvre cet article pour ce qu'il est, une enquête publiée par un fournisseur qui vend précisément la plateforme que ses conclusions appellent, et ses chiffres méritent d'être maniés avec cette précaution. Ce qui reste après cette réserve est solide, parce que les données indépendantes pointent dans la même direction en la précisant : la mise à niveau dont la plupart des organisations ont besoin n'est pas une question de machines, c'est une question de définitions. Un agent ne compense pas l'ambiguïté de vos données, il l'amplifie et la présente avec assurance, ce qui est la pire combinaison possible pour une décision.
Sources : As of July 2026
- [Primary] Your AI agents are ready. Is your data? — Sirish Chandrasekaran, Google Cloud — 23 juillet 2026 — https://cloud.google.com/blog/topics/ai-infrastructure/state-of-ai-infrastructure-report-and-the-agentic-data-cloud
- [Primary] 2026 State of infrastructure in the agentic AI era — Google Cloud — juillet 2026 — https://cloud.google.com/resources/content/state-of-infrastructure-in-the-agentic-ai-era
- [Primary] Report: 83% of organizations need to upgrade their infrastructure to support agentic AI — Drew Bradstock, Google Cloud — juillet 2026 — https://cloud.google.com/blog/products/compute/state-of-ai-infrastructure-report-overview
- [Primary] A Semantic-Layer-Mediated Agent for Natural Language to SQL over Heterogeneous Enterprise Databases — arXiv:2606.31041 — juin 2026 — https://arxiv.org/abs/2606.31041
- [Primary] Long-Horizon-Terminal-Bench: Testing the Limits of Agents on Long-Horizon Terminal Tasks with Dense Reward-Based Grading — Zongxia Li et al. (arXiv:2607.08964) — 9 juillet 2026 — https://arxiv.org/abs/2607.08964
- [Secondary] Semantic Layer vs. Text-to-SQL: 2026 Benchmark Update — dbt Labs — 2026 — https://docs.getdbt.com/blog/semantic-layer-vs-text-to-sql-2026
- [Secondary] Text-to-SQL for Enterprise: Metric Drift and Context Layer — Atlan — 2026 — https://atlan.com/know/ai-agent/data-for-ai/text-to-sql-for-enterprise/
- [Secondary] Google Cloud Says 83% of Organizations Need Agentic AI Infrastructure Upgrades — eWeek — juillet 2026 — https://www.eweek.com/news/agentic-ai-infrastructure-upgrades/
Comments ()