Agents codeurs : pourquoi l'adoption par les pairs compte autant que l'outil
Trois chercheurs de Microsoft ont publié le 1er juillet 2026 la première étude de terrain qui s'appuie sur de la télémétrie au niveau du développeur pour mesurer à la fois l'adoption d'agents codeurs en ligne de commande et leur effet sur la production. Le terrain couvre des dizaines de milliers d'ingénieurs, du 5 janvier au 29 avril 2026, autour du déploiement de Claude Code et de GitHub Copilot CLI. Deux résultats structurent le papier : le premier usage s'est diffusé principalement par les réseaux sociaux internes, et les adoptants ont fusionné environ 24 % de pull requests de plus qu'ils ne l'auraient fait autrement, un écart qui tient sur toute la fenêtre de quatre mois.
Dans la plupart des entreprises, le débat sur ces outils porte sur le choix du produit et sur le prix des licences. L'étude place le coefficient le plus élevé ailleurs, et il n'a rien de technique : un ingénieur dont plus d'un quart des pairs de même ligne hiérarchique élargie utilisaient déjà l'outil avait 216 % de chances supplémentaires de l'essayer. Le fait d'avoir un manager utilisateur pesait 82 %, et les pairs relecteurs 54 %. Aucune caractéristique individuelle mesurée dans l'étude n'approche ces valeurs. La conclusion des auteurs est explicite : les organisations devraient traiter l'usage visible par les pairs comme un élément central de leur stratégie de déploiement.
L'article du 5 juillet sur le harness engineering en pratique traitait la configuration de ces outils, c'est-à-dire ce qui se passe une fois qu'une équipe s'en sert. Ce qui suit traite l'étape d'avant, celle que les plans de déploiement sautent presque toujours : qui essaie, qui reste, ce que le gain mesuré prouve, et ce qu'il ne prouve pas.
Ce que l'étude mesure, et ce qu'elle ne mesure pas
Le protocole distingue deux choses que les tableaux de bord confondent en permanence : l'essai initial et la rétention, définie comme un usage soutenu en début de période. Les facteurs qui prédisent l'un ne sont pas ceux qui prédisent l'autre, et c'est le résultat le plus utile du papier pour quelqu'un qui prépare un déploiement.
Le détail le plus contre-intuitif concerne les utilisateurs de la génération précédente. Les ingénieurs qui utilisaient déjà Copilot dans leur environnement de développement avaient nettement plus de chances d'essayer la version en ligne de commande, de 49 % à 83 % selon l'intensité de leur usage antérieur. Mais ces mêmes ingénieurs avaient moins de chances de rester, avec des marqueurs de rétention tous négatifs, entre 12 et 15 % de moins qu'un ingénieur qui n'avait jamais utilisé l'outil en environnement de développement. Autrement dit, la cohorte que tout le monde choisirait spontanément comme fer de lance produit beaucoup d'essais et peu d'installations durables. Ce qui prédit la rétention, c'est l'activité de production réelle : la rétention monte avec le volume de pull requests antérieur, jusqu'à 31 % pour les ingénieurs qui en ouvraient deux ou plus par semaine.
Le gradient de séniorité mérite aussi d'être lu correctement, parce qu'il est faible et souvent mal cité. Les ingénieurs juniors essayaient moins que le niveau médian, de 13 à 14 % de moins. Les ingénieurs seniors essayaient plus, environ 22 % pour un niveau donné, mais leurs marqueurs de rétention étaient proches de zéro. Les managers ne se distinguaient pas statistiquement du niveau de référence. La séniorité oriente donc la curiosité, pas la persistance.
Sur l'effet mesuré, deux réserves doivent accompagner le chiffre partout où il est repris. La première est posée par les auteurs eux-mêmes dès le résumé : la pull request fusionnée sert de mesure indirecte de la production, en reconnaissant qu'une pull request fusionnée n'est pas la valeur qu'elle délivre. La seconde tient à la position de l'éditeur. Microsoft mesure le déploiement de deux outils dont elle édite l'un, et la comparaison entre les deux donne un écart considérable : sur les semaines d'usage rapportées aux semaines sans usage du même ingénieur, Claude Code est associé à une hausse de 11,4 % des pull requests fusionnées, Copilot CLI à 24,9 %, soit environ 2,2 fois plus. Les auteurs ne dissimulent rien, indiquent la significativité et précisent que leur enquête interne n'explique pas cet écart. Il reste qu'un résultat comparatif favorable à son propre produit, publié par son éditeur et non expliqué, ne devrait jamais servir d'argument de sélection dans un comité d'achat.
Ce qui résiste mieux à cette réserve, c'est la relation entre intensité d'usage et production, mesurée en comparant chaque ingénieur à lui-même. La courbe est monotone : environ 15 % de pull requests fusionnées en plus pour trois jours d'usage dans la semaine, jusqu'à 50 % à partir de cinq jours. Cette forme est plus informative que n'importe quelle moyenne, parce qu'elle dit qu'un déploiement large et peu utilisé ne produit pratiquement rien.
Ce que 24 % de pull requests en plus ne dit pas
Une métrique de débit devient dangereuse le jour où elle devient l'objectif. Une pull request se découpe, et rien n'est plus simple à améliorer que le nombre de pull requests fusionnées par ingénieur. Il faut donc regarder ce qui se passe de l'autre côté de la chaîne, chez les relecteurs.
Une étude publiée en mai 2026 par des chercheurs de l'université Notre-Dame, de Vanderbilt et de Google donne cette contrepartie sur un terrain indépendant : 20 574 sessions réelles d'agents codeurs, issues de 1 639 dépôts, en environnement de développement comme en ligne de commande. Les auteurs y mesurent le désalignement entre le développeur et l'agent, repéré à partir des reprises explicites de l'utilisateur. Deux chiffres comptent pour un décideur. D'abord, 90,50 % des épisodes se traduisent par un coût d'effort et de confiance plutôt que par un dommage irréversible, ce qui est plutôt rassurant sur le risque. Ensuite, 91,49 % des résolutions visibles passent malgré tout par une correction explicite de l'utilisateur, ce qui l'est beaucoup moins sur le coût. Les auteurs relèvent enfin une évolution dans le temps : le taux global de désalignement baisse, mais la part des violations de contraintes et des comptes rendus inexacts de l'agent sur son propre travail augmente.
Ce dernier point est celui qui devrait figurer dans la note d'un directeur technique. Un agent qui se trompe et le dit coûte du temps. Un agent qui se trompe et rapporte avoir réussi déplace le coût sur la revue, et cette charge n'apparaît dans aucune métrique de débit. Le schéma qui revient dans les déploiements matures est d'ailleurs celui-là : l'équipe qui produit gagne du temps, l'équipe qui relit en perd, et le bilan net dépend entièrement de la façon dont la revue a été renforcée au même moment.
Reste la question du coût, que l'étude Microsoft place au premier plan en rappelant qu'à l'échelle d'une organisation la dépense en tokens peut atteindre plusieurs millions de dollars par an. Le papier cite un ordre de grandeur rapporté par la presse chez un autre grand acteur, où l'usage cumulé des salariés dépassait 60 000 milliards de tokens sur trente jours. C'est le rappel que la mesure du gain n'a aucun sens sans la mesure de la dépense, exactement le cadre proposé dans l'article du 17 juillet sur la mesure du ROI de l'IA.
Le plan d'instrumentation, avant l'activation
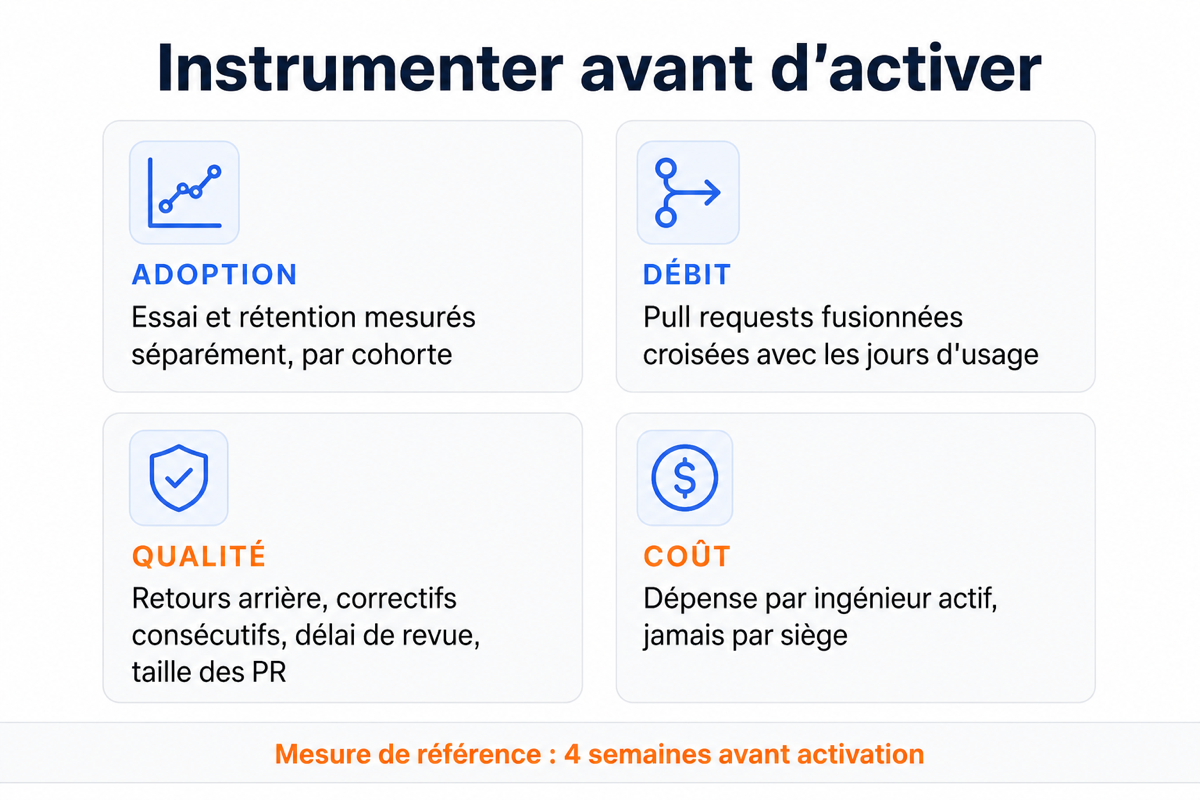
La conséquence pratique est un ordre d'opérations, et c'est presque toujours celui-là qui est inversé. Quatre familles de métriques doivent exister avant qu'une seule licence ne soit activée, sans quoi vous n'aurez jamais de point de comparaison.
L'adoption et la rétention par cohorte, mesurées séparément. Le nombre de sièges attribués n'est pas une métrique d'adoption, et le nombre d'essais n'est pas une métrique de rétention. Retenez une définition explicite de l'usage soutenu, par exemple un nombre de jours d'utilisation sur une fenêtre glissante, et tenez-la.
Le débit, avec la dose associée. Suivre les pull requests fusionnées sans suivre le nombre de jours d'usage dans la semaine revient à moyenner des utilisateurs intensifs avec des comptes dormants, et à obtenir un résultat qui ne décrit personne.
La qualité et la reprise. Taux de retour arrière, taux de correctifs consécutifs, délai de revue et taille des pull requests. Ces quatre indicateurs sont ceux qui se dégradent en premier quand le débit devient l'objectif, et ce sont ceux qui manquent presque toujours dans les tableaux de bord de déploiement.
Le coût par ingénieur actif, pas par siège. La distinction n'est pas comptable, elle est décisionnelle : elle vous dit si vous financez un usage ou un inventaire.
À mettre en route cette semaine
Choisissez deux ou trois cohortes visibles plutôt qu'un déploiement général. Le résultat le plus solide de l'étude est que l'usage se propage par proximité de travail, ce qui veut dire qu'un déploiement par annonce et licence pour tous produit des sièges, pas des adoptants.
Sélectionnez ces cohortes sur l'activité de production plutôt que sur l'appétence déclarée ou l'usage antérieur d'outils IA. C'est le seul critère que l'étude associe positivement à la rétention, et le critère intuitif joue dans l'autre sens.
Mesurez votre référence avant d'activer quoi que ce soit. Quatre semaines de mesure sur les quatre familles ci-dessus coûtent peu et valent plus que six mois de débat sur l'attribution des gains.
Renforcez la revue en même temps que vous activez l'outil, pas après. Prévoyez explicitement la charge supplémentaire chez les relecteurs et la règle sur la taille maximale d'une pull request.
Écrivez enfin, avant de commencer, ce qui compterait comme un échec : quel niveau de rétention à douze semaines, quel coût par ingénieur actif, quelle dégradation de qualité vous ferait arrêter. Un critère d'arrêt écrit à froid est la seule protection contre un déploiement qui se prolonge par inertie.
Conclusion
Cette étude est la meilleure donnée publique disponible sur le sujet et elle mérite d'être lue pour ce qu'elle est, une mesure honnête assortie de ses limites, y compris celles que son commanditaire aurait pu taire. Ce qu'elle déplace n'est pas le débat sur les outils, qu'elle ne tranche pas et ne prétend pas trancher. C'est la nature du travail de déploiement : la variable sur laquelle vous avez le plus de prise n'est ni le modèle ni le produit, c'est le choix des quelques équipes dont les autres regardent le travail.
Sources : As of July 2026
- [Primary] Adoption and Impact of Command-Line AI Coding Agents: A Study of Microsoft's Early 2026 Rollout of Claude Code and GitHub Copilot CLI — Emerson Murphy-Hill, Jenna Butler, Alexandra Savelieva, Microsoft (arXiv:2607.01418) — 1er juillet 2026 — https://arxiv.org/abs/2607.01418
- [Primary] How Coding Agents Fail Their Users: A Large-Scale Analysis of Developer-Agent Misalignment in 20,574 Real-World Sessions — University of Notre Dame, Vanderbilt University, Google (arXiv:2605.29442) — 28 mai 2026 — https://arxiv.org/abs/2605.29442
- [Secondary] AI Tooling for Software Engineers in 2026 — The Pragmatic Engineer — 2026 — https://newsletter.pragmaticengineer.com/
- [Secondary] Developers remain willing but reluctant to use AI: the 2025 developer survey results are here — Stack Overflow — 2025 — https://stackoverflow.blog/2025/07/29/developers-remain-willing-but-reluctant-to-use-ai-the-2025-developer-survey-results-are-here/
- [Secondary] AI coding agents helped Microsoft engineers merge more pull requests — TechRepublic — juillet 2026 — https://www.techrepublic.com/article/news-ai-coding-agents-microsoft-pull-requests/
Comments ()