Votre benchmark d'agent vous donne une note, pas une carte de ses limites
Un benchmark publié sur arXiv le 9 juillet 2026 illustre mieux que n'importe quel argumentaire ce que l'évaluation d'agents ne mesure pas. Long-Horizon-Terminal-Bench réunit 46 tâches longues réparties en neuf catégories, de la reproduction d'expérience au génie logiciel en passant par le calcul scientifique, chacune décomposée en sous-tâches notées finement. Sur quinze modèles de pointe évalués, le meilleur atteint 15,2 % de réussite au premier essai avec un seuil de récompense partielle à 0,95, et 10,9 % au seuil parfait. La moyenne sur l'ensemble des modèles tombe à 4,3 % et 1,7 %. Les tâches consomment en moyenne 9,9 millions de tokens, environ 231 épisodes et 85,3 minutes d'exécution par exécution.
Le réflexe devant ces chiffres est d'y lire un verdict, favorable ou défavorable selon l'humeur du moment. C'est passer à côté du point de méthode, qui est la vraie contribution de ce travail. Les auteurs construisent une notation dense parce que l'évaluation par le seul résultat final ignore la progression intermédiaire et les solutions partielles, ce qui produit un signal creux et une image incomplète de la capacité. Formulé autrement, et c'est l'observation la plus utile de toute cette littérature : dans une tâche à plusieurs vérificateurs, une règle du tout ou rien attribue exactement le même zéro à une trajectoire qui ne satisfait aucune exigence et à une trajectoire qui les satisfait presque toutes. Or ces deux situations appellent des décisions opposées, l'une l'abandon, l'autre un ajustement de garde-fous.
L'article du 6 août sur le test de déterminisme proposait de décider étape par étape ce qui reste du code. Il supposait que vous saviez où votre agent décroche. Ce qui suit traite précisément cette question, et propose de remplacer la note unique par une cartographie de frontière, en faisant varier délibérément les paramètres qui déterminent la difficulté réelle.
Pourquoi un score unique cesse de discriminer
Deux mécanismes indépendants rendent la note trompeuse, et ils jouent dans des directions opposées.
Le premier est la saturation. Les benchmarks d'appel de fonctions approchent aujourd'hui un score de 0,97 chez les modèles de pointe, c'est-à-dire un plafond où un bon modèle et un très bon modèle rendent le même résultat. Un test saturé continue de tourner et de produire un chiffre rassurant, il a simplement cessé de séparer. Le phénomène est documenté depuis le début de l'année sur les jeux d'évaluation les plus repris du secteur, et il a une conséquence désagréable : plus un benchmark est cité, plus il a de chances d'avoir été optimisé, donc d'avoir perdu son pouvoir discriminant au moment précis où vous vous appuyez dessus.
Le second mécanisme est le décor. Un travail publié en juin 2026 sous le titre Running the Gauntlet réévalue les capacités d'agents en dehors des environnements familiers, et l'agent le plus performant y obtient 19,1 % de réussite. L'écart avec les scores publiés sur les benchmarks usuels ne dit pas que les modèles ont régressé, il dit que la performance mesurée était en partie une performance d'environnement. Un agent qui excelle dans un décor qu'il a beaucoup vu pendant son entraînement ne vous renseigne pas sur son comportement dans votre entrepôt de données, avec vos conventions de nommage et vos tables mal documentées.
Entre ces deux mécanismes, il reste un troisième facteur que presque aucune évaluation interne ne simule : la panne. Les travaux qui injectent des échecs d'appels d'outils, en rejetant aléatoirement une fraction des appels, observent qu'un taux d'échec même modeste de l'ordre de dix pour cent dégrade sensiblement la performance à tous les niveaux d'horizon et de difficulté. Votre environnement de production connaît des limitations de débit, des délais dépassés et des services indisponibles. Une évaluation qui se déroule dans des conditions parfaites mesure un agent que vous n'exécuterez jamais.
Cinq axes à faire varier plutôt qu'une note à publier
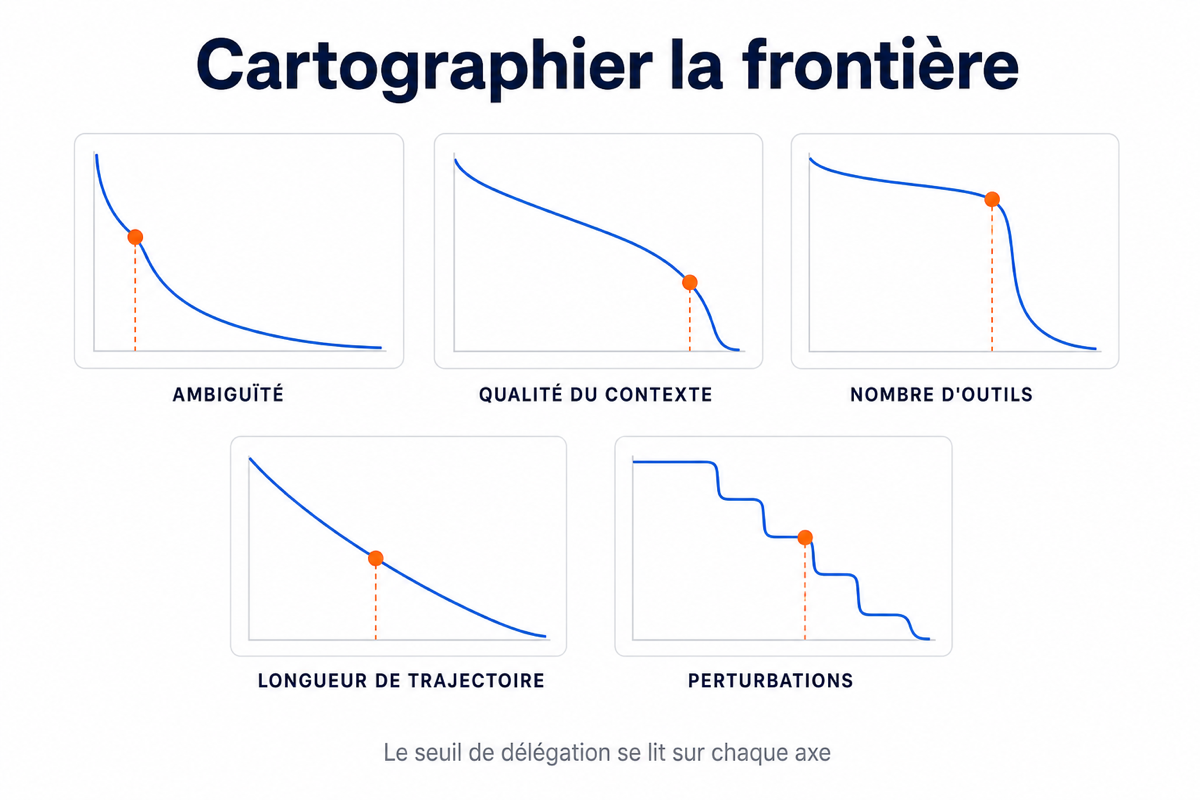
Passer d'une note à une carte demande de choisir les dimensions le long desquelles la difficulté augmente, puis de mesurer où la réussite décroche sur chacune. Cinq axes suffisent à couvrir l'essentiel, et ils sont indépendants les uns des autres.
L'ambiguïté de la demande. Rédigez la même tâche en trois niveaux de précision, d'une spécification complète à une formulation orale telle qu'un métier la produirait vraiment. C'est l'axe le plus prédictif, et c'est celui que les jeux d'évaluation internes standardisent involontairement, puisqu'ils sont écrits par des gens qui connaissent déjà la bonne réponse.
La qualité du contexte. Faites varier ce que l'agent reçoit : documentation à jour, documentation partiellement obsolète, documentation contradictoire. Sur un agent de données, cela se traduit très concrètement par la découverte de la bonne table dans un entrepôt où plusieurs tables portent des noms voisins et où deux d'entre elles sont abandonnées sans que rien ne l'indique.
Le nombre d'outils exposés. Mesurez la même tâche avec cinq outils disponibles, puis vingt, puis cinquante. La dégradation n'est pas linéaire, et le point de rupture vous donne directement la taille maximale de la boîte à outils que vous pouvez confier à cet agent.
La longueur de trajectoire. Le benchmark cité plus haut montre l'ordre de grandeur qu'implique le passage aux tâches longues, avec des centaines d'épisodes et des dizaines de minutes d'exécution. Mesurez la réussite à cinq étapes, vingt, cinquante, et regardez où la courbe s'effondre plutôt que de retenir une moyenne qui n'existe nulle part.
Les perturbations. Injectez des refus d'appels d'outils, des réponses lentes et des données manquantes. C'est la variation qui sépare une démonstration d'un composant de production, et c'est la moins coûteuse à mettre en place puisqu'elle ne demande aucune nouvelle tâche, seulement un intercepteur.
Ce que la carte permet, que la note interdit
L'intérêt de ce déplacement est décisionnel avant d'être scientifique. Une note vous autorise deux verdicts, déployer ou renoncer. Une carte vous en donne un troisième, de loin le plus fréquent en pratique : déployer à l'intérieur d'un périmètre dont vous connaissez les bords.
Les plateformes ont commencé à outiller cette approche. Google Cloud a rendu généralement disponibles fin juillet 2026 des évaluations d'agents et de modèles dans sa plateforme d'agents d'entreprise, avec plus de vingt métriques prédéfinies couvrant la qualité, la sécurité, l'ancrage documentaire, l'usage des outils et la trajectoire. Le point notable n'est pas le nombre de métriques mais l'abandon revendiqué du juge unique : des grilles adaptatives ajustent les critères d'évaluation à chaque cas plutôt que d'appliquer une seule consigne de jugement, fragile, à des entrées qui ne méritent pas les mêmes questions. C'est la même intuition que la notation dense, transposée dans un produit.
Il faut lire cette convergence pour ce qu'elle est : un éditeur qui vend une plateforme d'agents a intérêt à ce que l'évaluation devienne un produit, et le fait qu'il propose des juges automatiques ne règle pas la question de savoir qui évalue les juges. Mais le mouvement de fond est cohérent avec la recherche indépendante, et il pointe dans la même direction que l'article du 9 juillet sur la grille de délégation aux agents : ce qui est exploitable pour décider, ce n'est pas le niveau de performance moyen, c'est la position de la frontière.
Le schéma qui revient dans les équipes qui ont dépassé le pilote est d'ailleurs celui-là. Elles ne cherchent plus à savoir si leur agent est bon, question à laquelle personne ne sait répondre, mais à quel endroit précis il cesse de l'être, information qu'elles convertissent en règles de routage, en plafonds d'itérations et en points de reprise humaine.
À mettre en route cette semaine
Reprenez votre jeu d'évaluation actuel et vérifiez d'abord s'il sature. Si tous vos candidats obtiennent des scores proches et élevés, votre test ne mesure plus rien et le remplacer est plus urgent que de comparer des modèles.
Ajoutez la récompense partielle. Découpez au moins une tâche représentative en sous-tâches notées séparément, pour distinguer l'échec complet de l'échec au dernier pas. Ces deux résultats mènent à des décisions différentes et votre notation actuelle les confond probablement.
Écrivez trois versions de la même demande, de la plus spécifiée à la plus ambiguë, et mesurez l'écart. Si la performance s'effondre entre la version un et la version trois, votre problème n'est pas le modèle, il est dans l'interface entre le métier et l'agent.
Branchez un intercepteur qui rejette aléatoirement dix pour cent des appels d'outils et relancez votre évaluation. Le résultat vous dira si vous avez mesuré un agent ou des conditions de laboratoire.
Documentez enfin la frontière obtenue en une page, avec pour chaque axe le seuil au-delà duquel vous ne déléguez plus. C'est ce document, et non le score, qui doit accompagner l'agent en production.
Conclusion
L'évaluation d'agents traverse le même passage que la mesure de disponibilité des systèmes distribués il y a vingt ans, quand un pourcentage global a cessé de décrire quoi que ce soit d'utile et a été remplacé par des mesures par service, par région et par percentile. La note unique survit parce qu'elle se compare facilement et se met dans une diapositive, pas parce qu'elle informe. Ce qu'un directeur technique a besoin de savoir n'a jamais été le score de son agent, c'est l'endroit exact où il cesse de tenir, et cet endroit ne s'obtient qu'en le cherchant.
Sources : As of July 2026
- [Primary] Long-Horizon-Terminal-Bench: Testing the Limits of Agents on Long-Horizon Terminal Tasks with Dense Reward-Based Grading — Zongxia Li et al. (arXiv:2607.08964) — 9 juillet 2026, révisé le 13 juillet 2026 — https://arxiv.org/abs/2607.08964
- [Primary] Running the Gauntlet: Re-evaluating the Capabilities of Agents Beyond Familiar Environments — arXiv:2606.14397 — juin 2026 — https://arxiv.org/abs/2606.14397
- [Primary] Evaluate agent performance — Google Cloud — juillet 2026 — https://cloud.google.com/blog/products/data-analytics/evaluate-agent-performance
- [Primary] Agent and Model Evaluations in Gemini Enterprise Agent Platform are now GA — Google Developers Blog — 31 juillet 2026 — https://developers.googleblog.com/agent-and-model-evaluations-in-gemini-enterprise-agent-platform-are-now-ga/
- [Secondary] A methodical approach to agent evaluation — Google Cloud — 2026 — https://cloud.google.com/blog/topics/developers-practitioners/a-methodical-approach-to-agent-evaluation
- [Secondary] AI Agent Evaluation Stack in 2026: Beyond Saturated SWE-bench Scores — Zylos Research — 25 mars 2026 — https://zylos.ai/research/2026-03-25-ai-agent-evaluation-stack-2026-beyond-swe-bench/
Comments ()