Le préavis minimum de votre fournisseur est devenu son calendrier réel
Le 24 septembre 2026, l'API Videos d'OpenAI et toute la famille sora-2 cessent de répondre. Quatre jours plus tard, le 28 septembre, gpt-3.5-turbo-instruct, babbage-002, davinci-002 et gpt-3.5-turbo-1106 disparaissent à leur tour. Ces deux échéances tombent à vingt-trois et vingt-sept jours de la lecture de cet article, et elles ont été annoncées respectivement le 24 mars 2026 et le 26 septembre 2025 sur la page Deprecations d'OpenAI. Personne n'a été pris par surprise. Beaucoup d'équipes le seront quand même.
La lecture courante des politiques de dépréciation est rassurante. OpenAI s'engage sur au moins six mois pour ses modèles en disponibilité générale, Anthropic sur au moins soixante jours pour ses modèles publics. Un plancher, donc, avec l'idée implicite que la pratique sera plus généreuse. Les deux historiques publics disent le contraire. Sur les cinq dernières annonces de retrait de modèles GA chez OpenAI, le préavis effectif a été de 182, 183, 184, 184 et 184 jours. Sur les quatre dernières chez Anthropic, de 60, 61, 62 et 62 jours. Le plancher n'est pas une garantie minimale au-dessus de laquelle le fournisseur navigue, c'est l'horaire de départ du train.
L'article du 28 août sur la qualification d'un fournisseur anonyme traitait de ce qu'il faut vérifier avant d'envoyer le premier appel. Celui-ci traite de la fin de vie de la même intégration : ce qui casse après, quand le fournisseur retire ou remplace ce que votre code appelle. Ce qui suit détaille pourquoi le préavis varie d'un facteur trois selon le fournisseur et d'un facteur deux à l'intérieur du même catalogue, pourquoi ce n'est pas toujours un modèle qui vous casse, et ce que coûte réellement une migration mesurée en production.
Trois régimes de préavis pour une seule décision d'architecture
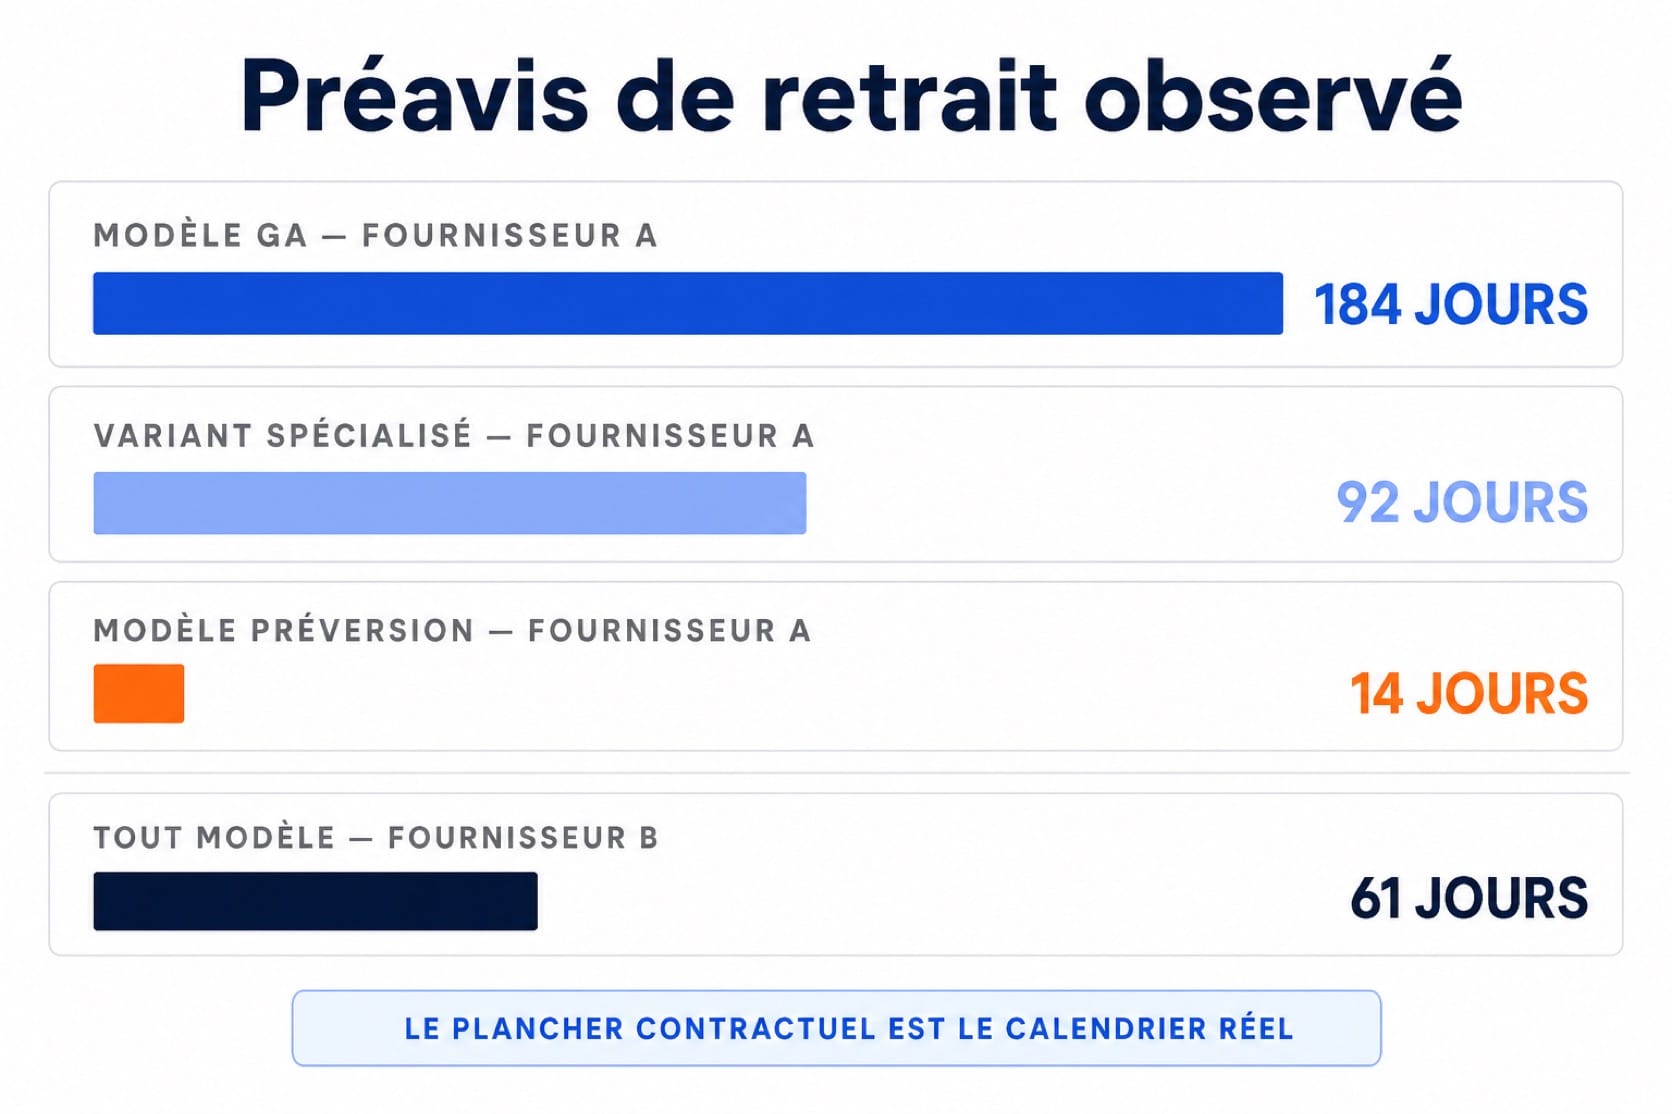
OpenAI publie trois engagements distincts, et la distinction est plus lourde de conséquences que la plupart des équipes ne le supposent. Au moins six mois pour les modèles en disponibilité générale. Au moins trois mois pour les variants spécialisés de ces mêmes modèles, catégorie qui couvre les variants de chat comme gpt-5.1-chat-latest, les variants Codex comme gpt-5.3-codex et les variants de recherche approfondie comme o3-deep-research. Et pour les modèles préversion, identifiables au mot preview dans leur nom, un préavis qui peut descendre à deux semaines, avec une recommandation explicite de la documentation : ne pas les utiliser sur des charges de production critiques sans capacité de migration à très court terme.
Anthropic n'a qu'un seul régime, au moins soixante jours pour tout modèle publiquement diffusé. Le calcul sur l'historique complet de sa page de dépréciations, dix-neuf modèles et neuf annonces depuis septembre 2024, donne une médiane de 63 jours. La dispersion est instructive : 189 et 181 jours pour les annonces de 2025, puis 60, 61, 62 et 62 jours pour les quatre plus récentes. Le préavis s'est resserré sur le plancher contractuel à mesure que la cadence de sortie s'accélérait.
Les mots du cycle de vie
Snapshot daté : identifiant de modèle figé sur une version précise, du type claude-opus-4-5-20251101 ou gpt-5-2025-08-07. Le comportement du modèle derrière cet identifiant ne change plus.
Alias flottant : identifiant sans date, du type gpt-5.1-chat-latest, qui pointe vers une version que le fournisseur peut faire évoluer sans notification et sans changement de nom.
Deprecated : le modèle fonctionne encore mais n'est plus recommandé, une date de retrait lui est assignée. Retired ou shut down : les appels échouent, sans mode dégradé ni période de grâce.
Variant spécialisé : déclinaison d'un modèle GA pour un usage précis, code, chat ou recherche. Chez OpenAI, cette catégorie relève d'un préavis de trois mois et non de six.
Le variant qui semblait le bon choix technique divise votre préavis par deux
Le 22 avril 2026, OpenAI a annoncé le retrait, au 23 juillet suivant, de gpt-5-codex, gpt-5.1-codex, gpt-5.1-codex-max, gpt-5.1-codex-mini, gpt-5.2-codex, gpt-5-chat-latest, gpt-5.1-chat-latest, ainsi que des variants de recherche approfondie o3-deep-research et o4-mini-deep-research. Préavis effectif : 92 jours. Le 8 mai, gpt-5.2-chat-latest et gpt-5.3-chat-latest ont reçu 94 jours. Le même mois, les modèles GA de la famille GPT-5 et o3 recevaient 183 jours.
Une équipe qui a standardisé ses agents de code sur un variant Codex a donc disposé de trois mois là où une équipe restée sur le snapshot GA en avait six, pour un choix qui, au moment où il a été fait, ressemblait au choix technique le plus soigné. C'est le point que les revues d'architecture ratent le plus souvent : la spécialisation d'un modèle est une décision de niveau de service autant qu'une décision de qualité.
Le second piège concerne les alias flottants. Un identifiant en -latest est souvent adopté parce qu'il paraît neutre, une manière de rester à jour sans y penser. L'historique d'OpenAI montre que ces alias n'ont pas mieux résisté que les autres : chatgpt-4o-latest, codex-mini-latest, gpt-5-chat-latest, gpt-5.1-chat-latest, gpt-5.2-chat-latest et gpt-5.3-chat-latest ont tous été retirés, et tous sur le régime court de trois mois. Un alias ne vous protège pas d'un retrait, il vous prive seulement du signal qui vous aurait averti d'un changement de comportement entre-temps.
Ce qui casse n'est pas toujours un modèle
Deux catégories de rupture échappent complètement à un inventaire construit autour des identifiants de modèles.
La première est la dépréciation de paramètres. Chez Anthropic, temperature, top_p et top_k renvoient une erreur 400 lorsqu'ils sont positionnés à une valeur non par défaut sur Claude Opus 4.7 et les modèles ultérieurs. Le SDK Python en version 1.0 et suivantes les a retirés de ses types de requête, si bien qu'un appel qui les transmet lève une TypeError. Aucun modèle n'a été retiré dans cette histoire : c'est une montée de version qui casse le code, et elle ne figure sur aucune date de shutdown.
La seconde est la dépréciation de produits d'outillage. Chez OpenAI, l'API v1/prompts et les objets de prompt réutilisables s'arrêtent le 30 novembre 2026, la plateforme Evals passe en lecture seule le 31 octobre puis s'arrête le 30 novembre, et Agent Builder s'arrête le 30 novembre également. Les équipes qui avaient externalisé leurs prompts dans les objets réutilisables du fournisseur, ou leur harnais d'évaluation dans sa plateforme d'evals, découvrent que la couche qui devait sécuriser leurs migrations de modèles est elle-même sur un compte à rebours. Le calendrier de fin de vie ne concerne pas seulement ce que vous appelez, il concerne aussi ce avec quoi vous mesurez.
Le cas de l'API Assistants mérite d'être cité pour la raison inverse. Annoncée le 26 août 2025, arrêtée le 26 août 2026, elle a bénéficié d'un préavis de 365 jours, et son arrêt s'est fait sans mode dégradé ni période de grâce. Un an de préavis n'a pas empêché des intégrations de tomber, parce que la migration vers les API Responses et Conversations imposait de remodeler des objets métiers, pas de changer une chaîne de caractères.
Ce que coûte réellement une migration, mesuré en production
Une équipe de Verint a publié fin avril 2026, sur arXiv, une étude de cas sur la migration d'un système de questions-réponses en production servant 5,3 millions d'échanges par mois dans six régions. Leur constat de départ est net : le cycle de dépréciation et de migration de modèles propriétaires se répète environ tous les douze mois et touche chaque produit construit sur le modèle retiré, avec des fenêtres de migration courtes qui rendent l'évaluation manuelle prohibitive.
Leur résultat le plus utile est celui qu'ils n'attendaient pas. Ils ont testé trois stratégies de réadaptation du prompt au nouveau modèle : adaptation manuelle suivant les recommandations du fournisseur, optimiseur automatique de la plateforme d'hébergement, et MIPROv2 via DSPy. Aucune n'a produit un prompt nettement meilleur que celui d'origine. Les prompts optimisés par DSPy ont bien réduit les erreurs, mais en augmentant fortement le taux de refus de répondre, et le gain ne se reproduisait pas sur un jeu de test hors distribution. Leur conclusion : le prompt de départ se généralise étonnamment bien d'un modèle à l'autre.
Autrement dit, la partie chère d'une migration n'est pas la réécriture du prompt, contrairement à ce que suppose la plupart des estimations de charge. La partie chère est le dispositif d'évaluation qui permet de savoir si quelque chose a cassé. Sur le terrain, les équipes qui ont déjà traversé deux ou trois cycles de retrait ne budgètent plus la migration au nombre de modèles à changer, elles la budgètent au nombre de jeux de régression à maintenir. C'est aussi ce qui explique que la même migration coûte quatre fois plus cher dans une organisation que dans une autre à périmètre technique comparable.
À mettre en route cette semaine
Cherchez dans votre code et vos configurations tout identifiant de modèle sans date. Un grep sur -latest, sur les noms de modèles sans suffixe de version et sur le mot preview suffit à produire la première liste. Chaque occurrence trouvée sur un chemin de production est une intégration dont vous ne connaissez ni la version réelle ni la date de retrait.
Construisez l'inventaire qui manque : un tableau à quatre colonnes, service appelant, identifiant de modèle épinglé, date de retrait annoncée par le fournisseur, propriétaire côté équipe. Les deux pages de dépréciations à surveiller sont publiques et datées, elles se lisent en vingt minutes chacune.
Provisionnez le budget de migration sur le préavis le plus court de votre parc, pas sur le plus long. Si un seul service tourne sur un variant spécialisé ou un modèle préversion, votre fenêtre de réaction réelle est de trois mois ou de deux semaines, quelle que soit la générosité du régime qui s'applique au reste.
Vérifiez ce sur quoi repose votre harnais d'évaluation. Si vos jeux de régression, vos prompts ou vos évaluations vivent dans un produit du fournisseur plutôt que dans votre dépôt, vérifiez sa date de fin de vie avant celle de vos modèles. L'outil qui doit sécuriser la migration ne doit pas expirer pendant la migration.
Traitez la ligne budgétaire comme récurrente. Deux à trois migrations par an et par fournisseur est le régime observé aujourd'hui, ce n'est plus un incident à absorber mais une charge de maintenance à planifier, au même titre que les montées de version de vos bases de données.
Conclusion
Le débat sur le choix d'un modèle porte presque toujours sur la qualité, la latence et le prix au million de tokens. Le préavis de retrait, lui, n'apparaît dans aucun comparatif, alors qu'il détermine la fréquence à laquelle vos équipes devront refaire le travail. Entre 184 jours pour un modèle GA chez un fournisseur, 92 jours pour un variant spécialisé chez le même, et 61 jours chez l'autre, la même décision d'architecture engage un rythme de maintenance qui varie du simple au triple. Cette information est publique, datée et gratuite. Elle mérite d'entrer dans la grille de choix avant la mise en production, pas trois semaines avant l'extinction.
Sources : As of August 2026
- [Primary] Deprecations, politique de préavis et calendrier complet des retraits — OpenAI — consultée le 30 août 2026 — https://developers.openai.com/api/docs/deprecations
- [Primary] Model deprecations, politique de notification et historique des retraits — Anthropic — consultée le 30 août 2026 — https://platform.claude.com/docs/en/about-claude/model-deprecations
- [Primary] When your LLM reaches end-of-life: a framework for confident model migration in production systems — Emma Casey, David Roberts, David Sim, Ian Beaver, Verint Systems, arXiv:2604.27082 — 29 avril 2026 — https://arxiv.org/abs/2604.27082
- [Primary] Commitments on model deprecation and preservation — Anthropic — 2025 — https://www.anthropic.com/research/deprecation-commitments
- [Secondary] Assistants API beta deprecation, August 26 2026 sunset — OpenAI Developer Community — 2026 — https://community.openai.com/t/assistants-api-beta-deprecation-august-26-2026-sunset/1354666
- [Secondary] OpenAI Assistants API will be deprecated in August 2026, what happens to Azure OpenAI — Microsoft Q&A — 2026 — https://learn.microsoft.com/en-us/answers/questions/5571874/openai-assistants-api-will-be-deprecated-in-august
- [Secondary] Anthropic model deprecations 2026, retirement dates and notice periods — llmlatency.dev — 2026 — https://llmlatency.dev/deprecations/anthropic
- [Secondary] AI model deprecation and lifecycle calendar, Anthropic, OpenAI, Google and Amazon Bedrock — Hidekazu Konishi — 2026 — https://hidekazu-konishi.com/entry/ai_model_deprecation_and_lifecycle_calendar.html
Comments ()