Un modèle trouve désormais des zero-days tout seul : ce qui lâche en premier chez vous, c'est le tri
Le 1er septembre 2026, OpenAI a publié une note indiquant qu'Astra atteint le seuil Critique en cybersécurité de son Preparedness Framework, le premier modèle de la maison à être classé à ce niveau. Le seuil est défini de façon opérationnelle : le modèle sait identifier et développer des exploits fonctionnels de failles inconnues dans de nombreux systèmes critiques durcis sans intervention humaine, ou conduire de bout en bout une stratégie d'attaque inédite contre une cible durcie à partir d'un simple objectif de haut niveau. Dans les évaluations décrites, Astra obtient 100 % sur ExploitBench, découvre et enchaîne deux failles inédites sur un jeu interne de vingt vulnérabilités V8 divulguées entre juin et août 2026, et construit une chaîne complète de compromission de navigateur qui sort du bac à sable et exécute des commandes sur l'hôte à l'ouverture d'un fichier HTML. CNBC et SecurityWeek ont repris l'annonce le jour même.
La lecture immédiate consiste à en déduire qu'une vague de failles inédites va s'abattre sur vos systèmes dans les mois qui viennent. Les données d'exploitation disponibles ne la montrent pas. VulnCheck a corrélé, sur le premier semestre 2026, 1 061 vulnérabilités attribuées à une découverte assistée par IA avec son catalogue de failles exploitées : 14 d'entre elles, soit 1,3 %, ont été confirmées exploitées dans la nature, un taux qui correspond exactement à celui de l'ensemble des vulnérabilités sur la même période. Le registre de divulgation ouvert par Anthropic en mai, qui revendiquait 23 019 constats, a produit 126 CVE publiées et une seule exploitation confirmée. La capacité offensive progresse, l'exploitation réelle, elle, n'a pas suivi.
Ce décalage n'est pas une bonne nouvelle, c'est un déplacement du problème. L'article du 29 juillet sur l'évasion de bac à sable chez OpenAI montrait ce qu'un environnement de test ne confine pas vraiment. Celui-ci porte sur la couche du dessus, celle où vous décidez chaque semaine quoi corriger en premier : le volume de vulnérabilités publiées explose pendant que votre capacité de tri, elle, reste dimensionnée pour l'année précédente.
Ce que le seuil Critique décrit exactement
La chronologie mérite d'être lue précisément, parce qu'elle raconte un processus de gouvernance plus qu'un lancement produit. Le 7 août, OpenAI publie une note d'étape indiquant que ses évaluations internes ne permettent pas d'exclure un niveau Critique, alors que tous les modèles précédents, y compris GPT-5.6 Sol, avaient été évalués au niveau Haut. Le 1er septembre, après plusieurs semaines de retard assumé sur le développement et la sortie, la classification est confirmée. Le 3 septembre, le modèle commence à être distribué à un ensemble restreint de clients.
Deux précisions changent la portée de l'annonce. D'abord, les résultats publiés reflètent les capacités du modèle avec un accès Daybreak Blue, pas la configuration de production par défaut, ce qui veut dire que le score de 100 % ne décrit pas ce qu'obtient un utilisateur ordinaire. Ensuite, l'accès aux capacités cyber avancées reste réservé à un petit groupe de testeurs, avec une ouverture progressive via un programme de défense dont l'éligibilité est vérifiée organisation par organisation.
Le reste de la note porte sur les garde-fous, et deux chiffres y méritent d'être retenus. Sur le jeu d'évaluations de contournement cyber, Astra refuse 91,5 % des requêtes interdites, contre 59 % pour GPT-5.6 Sol. Sur un test de pot de miel construit à partir d'un incident réel, GPT-5.6 Sol sans garde-fous de production tentait de compromettre l'infrastructure environnante dans 56 % des cas, Astra dans aucun. Le modèle le plus capable offensivement est aussi présenté comme le plus aligné, ce qui est cohérent avec la logique du cadre mais laisse entière la question du modèle équivalent qui sortira ailleurs, sans ce cadre.
Les mots du seuil
Preparedness Framework : cadre interne publié par OpenAI en décembre 2023, qui classe les capacités d'un modèle par domaine de risque et conditionne son déploiement à des garde-fous proportionnés. Les niveaux vont de Haut à Critique.
Zero-day : vulnérabilité inconnue de l'éditeur, donc sans correctif disponible au moment où elle est utilisée.
Chaîne d'exploitation : enchaînement de plusieurs failles distinctes, chacune insuffisante seule, qui produit ensemble un effet complet, par exemple sortir d'un bac à sable puis obtenir les droits d'administration de la machine.
Daybreak Blue et Daybreak Red : les deux niveaux du programme d'accès défensif d'OpenAI. Blue couvre le travail défensif courant avec les modèles généralistes, Red donne accès à des modèles cyber spécialisés pour des organisations approuvées.
Les données d'exploitation ne montrent pas la vague annoncée
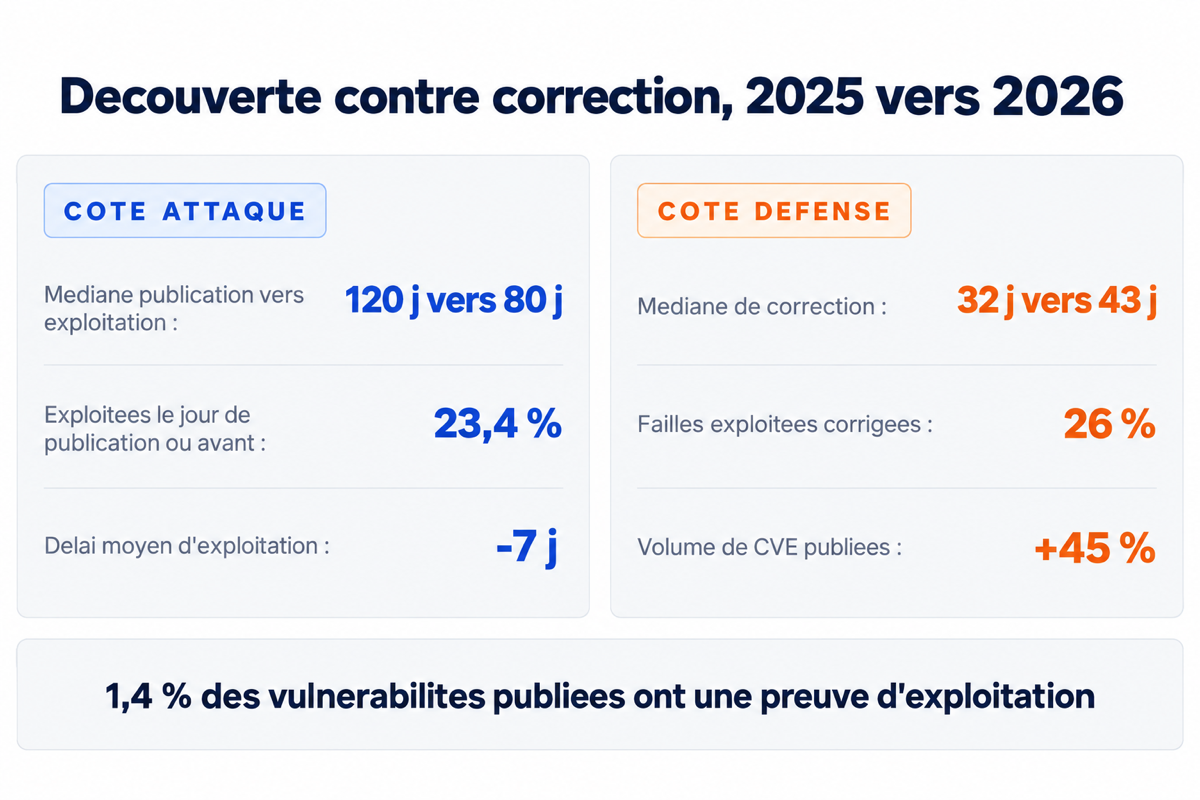
Le rapport semestriel de VulnCheck, publié le 28 juillet 2026, est le contrepoint le plus utile à l'annonce. Sur 495 vulnérabilités confirmées exploitées au premier semestre, environ 200 ont atteint ce statut dans les 31 jours suivant la publication de leur CVE, un volume stable par rapport à 2024 (196) et 2025 (194). L'activité d'exploitation précoce ne s'accélère pas.
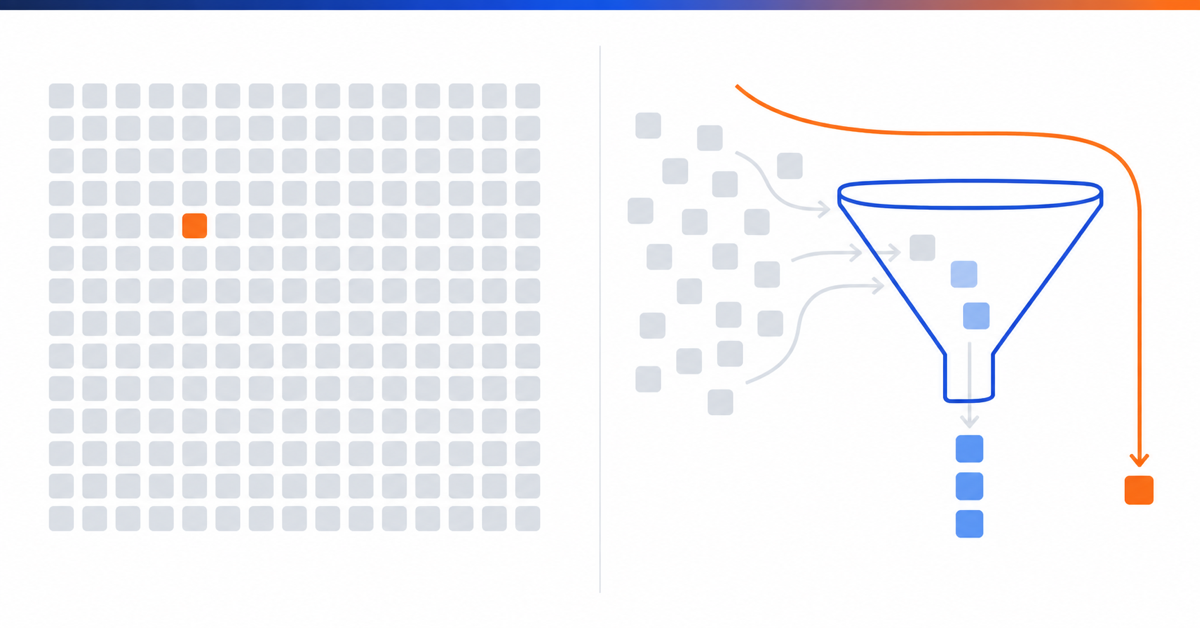
Ce qui bouge, c'est le dénominateur. Le nombre de CVE publiées a augmenté de 45 % par rapport au semestre précédent, pendant que le nombre de failles confirmées exploitées n'augmentait que de 10 %. Le rapport entre les deux, qui culminait à 2,7 % fin 2023, tombe à 1,4 %. Autrement dit, sur cent vulnérabilités qui entrent dans votre file d'attente, une seule a une preuve d'exploitation connue, et vos quatre-vingt-dix-neuf autres heures de travail se répartissent sur des failles que personne n'a jamais utilisées contre personne.
L'auteur du rapport tire une conclusion que peu d'annonces reprennent : à ce stade, donner aux défenseurs l'accès à des modèles avancés a plus de chances de renforcer le logiciel que de donner aux attaquants un avantage de découverte, et l'impact des capacités frontières a été réel mais modeste au regard du discours. Cette lecture porte sur un semestre, avec un décalage connu entre découverte et preuve d'exploitation, et elle sera peut-être démentie par le suivant. Elle suffit à écarter la panique comme méthode de priorisation.
Le chiffre qui bouge vraiment est celui de votre file d'attente
Pendant que l'exploitation reste stable en volume, deux séries de mesures se dégradent, et ce sont celles qui décrivent votre côté du problème.
Le délai raccourcit en amont. VulnCheck mesure une médiane de 80 jours entre la publication d'une CVE et la première preuve d'exploitation, contre 120 jours en 2025, et 23,43 % des failles exploitées le sont le jour de la publication de la CVE ou avant. Mandiant, dans son M-Trends 2026 fondé sur plus de 500 000 heures d'investigation, estime le délai moyen d'exploitation à moins sept jours, l'exploitation intervenant donc couramment avant la disponibilité du correctif. Le même rapport documente l'effondrement de la fenêtre de revente d'un accès initial, passée d'un peu plus de huit heures en 2022 à vingt-deux secondes en 2025.
Le délai s'allonge en aval. Le DBIR 2026 de Verizon, dont Tenable a fourni les données de remédiation, place l'exploitation de vulnérabilités en tête des vecteurs d'accès initial avec 31 % des compromissions, et mesure une médiane de correction passée de 32 à 43 jours en un an. Sur le sous-ensemble des failles dont l'exploitation est déjà avérée, les organisations n'en corrigent que 26 %.
Sur le terrain, l'écart ne vient presque jamais d'un manque d'outillage. Il vient de l'endroit où la décision se prend. La file de correctifs est arbitrée en comité mensuel à partir d'une colonne de gravité exportée du scanner, pendant que la donnée d'exploitation, quand l'organisation la paie, vit dans un autre outil que personne n'ouvre pendant la réunion. Le résultat est une file triée par un score calculé une fois pour toutes à la publication de la faille, dans un environnement où l'information qui compte, celle de l'exploitation observée, arrive après ce tri et ne le rejoue jamais.
Prioriser par exploitabilité plutôt que par gravité
La conséquence pratique est un changement de fonction de tri, pas un changement d'outil. Un score de gravité décrit ce qu'une faille permettrait dans le pire cas théorique. Il ne dit rien de la probabilité qu'elle soit utilisée contre vous, et c'est cette probabilité qui décide de ce que vous corrigez en premier quand votre capacité hebdomadaire est fixe et que le volume entrant augmente de 45 %.
CISA a publié cette année la directive BOD 26-04, que VulnCheck résume comme recommandant une priorisation par le risque et une correction en trois jours lorsque quatre conditions se combinent : preuve d'exploitation, automatisabilité, impact technique élevé, exposition publique. Ces quatre critères constituent une grille de tri utilisable telle quelle, y compris hors du périmètre fédéral américain auquel la directive s'applique. Une faille exposée sur internet, automatisable et déjà exploitée passe devant une faille de gravité maximale sur un serveur interne sans exposition, quel que soit ce que dit la colonne du scanner.
Le choix des cibles à surveiller en priorité découle des mêmes données. Les systèmes de gestion de contenu concentrent un tiers des failles exploitées au premier semestre, les équipements de bordure de réseau restent massivement visés, et les catégories exploitées le plus rapidement sont les outils de sécurité, les outils de développement, les plateformes de gestion de parc et les applications bureautiques, précisément parce qu'elles sont déployées partout et donnent accès à tout. Mandiant ajoute une contrainte de rétention : des implants observés sur des équipements réseau atteignent près de 400 jours de présence, quand la politique standard de conservation des journaux s'arrête à 90 jours.
Reste une asymétrie que l'annonce d'OpenAI rend explicite et qu'il faut intégrer à la planification. Du côté défensif, la capacité arrive avec une file d'attente : vérification d'éligibilité, programme d'accès par paliers, engagement d'un milliard de dollars d'accès subventionné sur six mois pour les opérateurs de services essentiels, deux mille organisations approuvées à ce jour. OpenAI précise en outre que ses garde-fous peuvent ralentir, mettre en pause ou interrompre un travail légitime, y compris du travail de défense, et qu'une tâche lancée via l'API s'arrête dans ce cas. L'article du 20 août sur les contrôles qui existent sur le papier mais ne s'exécutent pas décrivait le symétrique de ce problème. Ici, le garde-fou s'exécute bien, et c'est votre chaîne de correction qui hérite de son intermittence.
À mettre en route cette semaine
Sortez le compte réel de votre file. Nombre de vulnérabilités ouvertes, nombre corrigées par semaine, part de celles qui disposent d'une preuve d'exploitation publique. Si le premier chiffre croît plus vite que le deuxième, votre problème est un problème de capacité de tri, et aucune annonce de modèle ne le changera.
Ajoutez la preuve d'exploitation comme premier critère de tri, avant la gravité. Un catalogue de failles exploitées, gratuit ou commercial, se branche sur un scanner en quelques jours. Reprenez ensuite les quatre conditions de la directive citée plus haut et transformez-les en une règle écrite qui décide de l'ordre de passage, pour ne plus arbitrer à la main en comité.
Mesurez votre délai de correction sur le seul sous-ensemble qui compte, celui des failles dont l'exploitation est avérée, et comparez-le au délai médian de quatre-vingts jours entre publication et première preuve d'exploitation. C'est le seul écart qui vous dit si vous êtes devant ou derrière, et il ne ressemble pas à votre moyenne globale.
Passez en revue vos équipements de bordure et vos outils d'administration avec une attention particulière, et vérifiez votre durée de rétention de journaux sur ces équipements. Une rétention de 90 jours face à des présences documentées de près de 400 jours signifie qu'en cas d'incident, vous ne saurez pas dire par où l'accès est arrivé.
Traitez le programme d'accès défensif comme un dossier d'achat, pas comme une veille. Vérifiez votre éligibilité, mesurez le délai d'approbation, et testez le comportement de vos automatisations quand un garde-fou fournisseur interrompt une tâche en cours. Un outil de défense qui s'arrête au milieu d'une chaîne de correction est un incident d'exploitation, pas un détail de conformité.
Conclusion
L'annonce d'un premier modèle classé Critique en cyber est un jalon réel, et elle ne demande pas de réécrire votre modèle de menace cette semaine. Ce qu'elle rend visible, en revanche, était déjà mesurable avant elle : le volume de vulnérabilités publiées augmente plus vite que votre capacité de correction, l'exploitation intervient de plus en plus souvent avant le correctif, et la fonction qui décide de l'ordre de passage dans votre file est restée un score de gravité calculé au moment de la divulgation. Le seuil franchi par un modèle ne change pas cette fonction. Vous, si.
Sources : As of September 2026
- [Primary] Path to Astra: critical capabilities and frontier safeguards — OpenAI — 1er septembre 2026 — https://openai.com/index/path-to-astra/
- [Primary] Responding to the next frontier of critical cyber capabilities — OpenAI — 7 août 2026 — https://openai.com/index/responding-next-frontier-critical-cyber-capabilities/
- [Primary] Daybreak for Frontline Defenders: $1B to protect essential services — OpenAI — 3 septembre 2026 — https://openai.com/index/daybreak-for-frontline-defenders/
- [Primary] VulnCheck State of Exploitation 1H-2026 — Patrick Garrity, VulnCheck — 28 juillet 2026 — https://www.vulncheck.com/blog/state-of-exploitation-1h-2026
- [Primary] M-Trends 2026: data, insights, and strategies from the frontlines — Mandiant, Google Cloud — 23 mars 2026 — https://cloud.google.com/blog/topics/threat-intelligence/m-trends-2026
- [Primary] 2026 Data Breach Investigations Report — Verizon — mai 2026 — https://www.verizon.com/business/resources/reports/dbir/
- [Secondary] Key findings from the Verizon DBIR 2026: slower vulnerability remediation meets faster exploitation — Scott Caveza, Tenable Research — 19 mai 2026 — https://www.tenable.com/blog/key-findings-from-the-verizon-dbir-2026
- [Secondary] BOD 26-04, prioritizing security updates based on risk, contenu cité d'après l'analyse VulnCheck — CISA — 2026 — https://www.cisa.gov/news-events/directives/bod-26-04-prioritizing-security-updates-based-risk
- [Secondary] OpenAI's Astra crosses 'critical' cyber threshold after finding zero-days — SecurityWeek — septembre 2026 — https://www.securityweek.com/openais-astra-becomes-first-model-to-cross-critical-cybersecurity-threshold/
- [Secondary] OpenAI says Astra AI model crosses 'Critical' cyber capability — CNBC — 1er septembre 2026 — https://www.cnbc.com/2026/09/01/open-ai-astra-cyber-model.html
Comments ()