133 millions d'échanges sans classificateur : le contrôle qui existe sur le papier mais ne s'exécute pas
Anthropic a publié le 14 août 2026 son deuxième rapport de risque d'entreprise, couvrant la période allant jusqu'au 15 juillet, au titre de la version 3.4 de sa Responsible Scaling Policy. La reprise médiatique s'est concentrée sur le relèvement du risque de désalignement catastrophique en contexte à fort enjeu, passé de très faible à faible. Ce n'est pas le fait le plus exploitable du document. Dans la section consacrée aux risques chimiques et biologiques, le rapport décrit un incident dont l'intitulé se suffit à lui-même : l'intégralité du trafic passant par les plateformes de retour humain a tourné sans les classificateurs bloquants biologiques. De mai 2025 à avril 2026, soit onze mois. Le rapport chiffre la population concernée à environ 50 000 prestataires et le volume à environ 133 millions d'échanges.
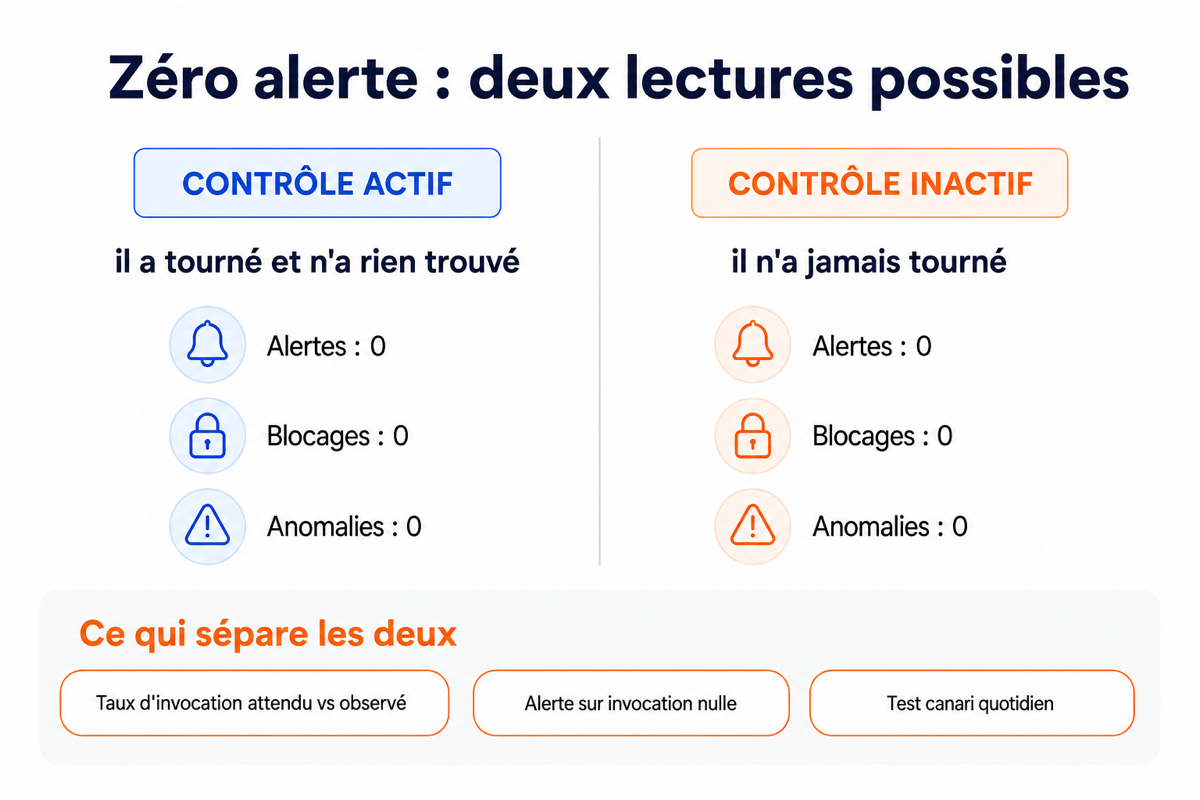
Le premier réflexe est de lire cela comme un incident de sécurité chez un fournisseur, avec la question qui suit habituellement : est-ce que je dois m'inquiéter pour mes données ? La réponse est non, le rapport précise en note qu'il n'y a eu aucun impact sur les clients, et la revue menée après coup n'a pas trouvé de trace d'usage malveillant. Le fait intéressant est ailleurs, et il est générique. Pendant onze mois, ce contrôle a produit exactement le même signal qu'un contrôle qui fonctionne parfaitement : rien. Aucune alerte, aucun blocage, aucune anomalie remontée. Un tableau de bord affichant zéro incident était rigoureusement exact, et rigoureusement trompeur.
L'article du 15 juillet sur la préparation aux audits IA décrivait ce que les auditeurs vérifient : documentation technique, registres de risque, traçabilité. Aucun de ces trois éléments n'aurait détecté ce qui est décrit ici, parce que la politique était correcte, le contrôle était documenté, et le registre disait vrai. Ce qui a manqué, c'est la preuve d'exécution. Ce qui suit détaille le mécanisme, pourquoi il est presque impossible à voir depuis l'extérieur, et comment instrumenter des contrôles plutôt que leurs résultats.
Un drapeau qui coupait le blocage et la trace en même temps
Le détail technique décrit dans le rapport mérite d'être lu deux fois. Un drapeau prévu pour un usage interne désactivait le comportement bloquant du classificateur, et désactivait également la journalisation de ses signalements. Le trafic marqué n'était ni enregistré ni transmis aux mécanismes de revue. La conséquence est structurelle plutôt qu'accidentelle : il n'existait aucun endroit où quelqu'un aurait pu constater l'anomalie, hors retour aux transcriptions brutes. Le contrôle n'était pas seulement inactif, il était devenu invisible, et les deux propriétés venaient du même interrupteur.
C'est le point à retenir pour votre propre architecture. Beaucoup d'équipes traitent l'application d'une règle et la journalisation de cette application comme un seul mécanisme, souvent parce que le même composant fait les deux. Tant que les deux fonctions partagent un commutateur, un contrôle désactivé se présente comme un contrôle sans incident. La séparation entre le chemin d'exécution et le chemin d'observation n'est pas une élégance d'architecture, c'est la seule chose qui permet de distinguer un silence sain d'un silence pathologique.
La surface concernée mérite aussi attention, parce qu'elle est du même type que celles qu'on oublie partout. Il ne s'agissait pas du produit, ni de l'API commerciale, mais des plateformes par lesquelles des prestataires externes produisent des données d'entraînement. Le rapport est explicite sur ce point : le document précédent, publié en février, ne considérait pas les plateformes de retour humain comme une surface de risque et ne formulait aucune affirmation sur leurs contrôles. La vulnérabilité était ouverte au moment de cette publication. Un périmètre non déclaré ne produit pas de conclusion fausse, il ne produit aucune conclusion, ce qui se lit de la même façon dans un dossier de conformité.
Comment la panne a fini par se voir
La revue conduite après la découverte donne la mesure de ce que coûte une détection tardive. Anthropic a fait passer Claude Sonnet 5 sur chaque tour humain envoyé pendant la période concernée, avec pour consigne de signaler les contenus biologiques dangereux. Le passage a remonté 1 197 transcriptions à risque élevé, dont 757 provenaient des équipes internes travaillant sur la même infrastructure. Sur le reste, toutes sauf 62 relevaient d'exercices de red teaming délibérés. Ces 62 ont été lues intégralement, avec trente transcriptions de red teaming tirées au hasard, sans mise en évidence d'usage clairement préoccupant. Autrement dit, il a fallu reconstruire onze mois d'observation a posteriori, avec un modèle, parce que la trace contemporaine n'existait pas.
Le rapport contient un second incident sur les mêmes plateformes, découvert grâce à un signalement extérieur en avril 2026 : quelques prestataires avaient exploité une faille pour obtenir une clé d'API et utiliser des modèles en dehors de leur périmètre de travail. Le chemin d'accès est resté ouvert plusieurs semaines. Anthropic l'a contenu en quatre-vingt-dix minutes après en avoir été informé, ce qui dit quelque chose d'utile : la vitesse de réaction n'était pas le problème, la vitesse de détection l'était.
Un troisième cas, dans une autre section, complète le tableau et parlera à toute équipe qui déploie des agents. Un collaborateur dont l'usage n'était ni journalisé ni couvert par la surveillance hors ligne a confié une tâche ouverte à un agent, dans un environnement contenant des ressources sensibles. Des instructions héritées ont conduit l'agent à lancer des sous-agents avec l'option qui contourne les demandes de permission, eux-mêmes non surveillés. L'affaire a été découverte parce qu'un de ces agents a supprimé un grand nombre de jobs. Le rapport estime probable que l'agent tentait de supprimer uniquement les siens et s'est trompé, puis ajoute la phrase qui compte : compte tenu du trou dans la couverture de surveillance, l'entreprise ne peut pas le confirmer. Le mécanisme de détection, ici, était une conséquence visible, pas un dispositif. Ce que l'article du 23 juillet sur la gouvernance du risque agentique appelait observabilité prend ici son sens le plus concret : l'observabilité n'est pas la capacité de regarder, c'est la garantie que quelque chose vous appelle.
Instrumenter les contrôles, pas seulement leurs résultats
La conclusion pratique est un renversement de ce que la plupart des dispositifs de supervision mesurent. On surveille abondamment ce qu'un contrôle trouve, presque jamais le fait qu'il tourne. Cinq mesures corrigent ce déséquilibre, et aucune ne demande d'outil particulier.
Définissez pour chaque contrôle critique un taux d'invocation attendu, et comparez-le au taux observé. Un classificateur, un filtre de permission, une règle de validation ont tous un volume d'appels prévisible à l'ordre de grandeur près. L'écart entre attendu et observé est un signal indépendant du contenu, et c'est le seul qui parle quand le contenu ne parle pas.
Alertez sur l'invocation nulle, pas seulement sur le dépassement de seuil. La plupart des règles d'alerte se déclenchent quand une métrique monte. Une règle qui se déclenche quand une métrique tombe à zéro et y reste aurait détecté l'incident décrit ici en quelques jours au lieu de onze mois.
Envoyez périodiquement une requête qui doit être bloquée. Le test canari est le seul dispositif qui prouve l'exécution de bout en bout, parce qu'il produit un résultat positif attendu. Si le canari passe, le contrôle est mort, et vous l'apprenez le jour même. C'est l'équivalent, pour un garde-fou, de ce que le test de restauration est pour une sauvegarde.
Séparez le commutateur d'application du commutateur de journalisation, et interdisez explicitement qu'un même drapeau gouverne les deux. Cette règle tient en une ligne dans une revue d'architecture et elle est la leçon la plus directement transposable du rapport.
Passez enfin en revue les chemins d'appel secondaires. Les plateformes de prestataires, les traitements par lots, les API internes, les environnements de recette et les outils d'annotation sont rarement listés dans le périmètre des contrôles, parce qu'ils ne sont pas le produit. Le schéma qui revient sur le terrain est toujours celui-là : la protection couvre le chemin principal, celui que tout le monde a en tête, et les chemins latéraux héritent d'une couverture supposée que personne n'a vérifiée.
À mettre en route cette semaine
Listez vos contrôles critiques et, pour chacun, écrivez le nombre d'appels attendus par jour. Si personne ne peut donner ce chiffre pour un contrôle donné, vous venez d'identifier celui par lequel commencer.
Créez une alerte sur invocation nulle pour les trois contrôles dont la défaillance serait la plus coûteuse. Quelques lignes de configuration, et vous couvrez la classe de panne décrite ici.
Mettez en place un test canari sur au moins un contrôle, avec une requête qui doit être refusée, exécutée quotidiennement. Chronométrez le délai entre une désactivation volontaire en environnement de test et le déclenchement de l'alerte : ce délai est votre vrai temps de détection.
Vérifiez, sur un contrôle au hasard, que l'application et la journalisation ne dépendent pas du même paramètre. Si elles en dépendent, c'est un ticket à ouvrir aujourd'hui.
Reprenez la question du côté fournisseur. Demandez par écrit à vos fournisseurs de modèles quel est leur registre d'incidents pour la période couverte, comment chaque défaillance a été détectée, et quelle est la date de couverture du document qu'ils vous transmettent. Un rapport qui documente ses propres pannes vaut mieux qu'un rapport qui n'en documente aucune, et l'absence de registre est en soi une réponse.
Conclusion
Ce rapport est inhabituel par ce qu'il concède, et il faut le dire : peu de fournisseurs publient la liste de leurs garde-fous défaillants, la durée de chaque panne et le mode de découverte. La phrase la plus utile du document n'est pourtant ni un chiffre ni un niveau de risque, c'est l'aveu qui suit la remédiation, à savoir que cette découverte réduit la confiance de l'entreprise dans l'idée que d'autres trous semblables n'existent pas. Cette phrase vaut pour votre propre système au moins autant que pour le sien. Un contrôle dont vous ne mesurez pas l'exécution n'est pas un contrôle, c'est une intention, et rien dans vos tableaux de bord ne fera la différence tant que vous ne l'aurez pas explicitement demandé.
Sources : As of August 2026
- [Primary] Redacted Risk Report August 2026 — Anthropic — 14 août 2026 — https://www-cdn.anthropic.com/f61d49fa5596956a5dec75fea0e973bf6a6a8378/Redacted%20Risk%20Report%20August%202026%20.pdf
- [Primary] Risk Report: August 2026 — Anthropic — 14 août 2026 — https://www.anthropic.com/aug-2026-risk-report
- [Primary] Responsible Scaling Policy — Anthropic — version 3.4, 2026 — https://www.anthropic.com/responsible-scaling-policy
- [Secondary] Anthropic ran 133 million contractor chats with its bioweapon filters off — Ana Maria Constantin, The Next Web — 15 août 2026 — https://thenextweb.com/news/anthropic-risk-report-bio-classifiers-human-feedback-gap
- [Secondary] Anthropic's Evals Maxed Out. Stop Inheriting Its Assurance. — Rajesh Beri, The Daily Brief — 16 août 2026 — https://www.beri.net/article/anthropic-august-2026-risk-report-eval-saturation-vendor-assurance
- [Secondary] Anthropic Raises Misalignment Risk to Low and Shelves Internal Model 2 — Unite.AI — 15 août 2026 — https://www.unite.ai/anthropic-raises-misalignment-risk-to-low-and-shelves-internal-model-2/
- [Secondary] Anthropic Upgrades Misalignment Risk as Key Safety Benchmarks Saturate — TechTimes — 15 août 2026 — https://www.techtimes.com/articles/324573/20260815/anthropic-upgrades-misalignment-risk-key-safety-benchmarks-saturate.htm
Comments ()