Ce qui quitte votre périmètre n'est pas votre donnée, c'est ce que le classificateur en a déduit
Le 19 août 2026, OpenAI a réaffirmé le Zero Data Retention pour ses modèles frontière et prévisualisé un dispositif appelé Private Safety Processing, conçu pour repérer des motifs à travers des interactions liées sans que son personnel accède au contenu. Deux mois et demi plus tôt, le 9 juin, Anthropic était passée en sens inverse : rétention obligatoire de trente jours des prompts et des sorties sur ses Covered Models, sur toutes les plateformes où ils sont proposés, y compris à travers AWS Bedrock, Google Cloud Agent Platform et Microsoft Foundry. Le 20 août, Bloomberg rapportait qu'Anthropic laisserait finalement ces trente jours résider dans le cloud du client, un plan confirmé publiquement par un de ses développeurs et attendu pour l'automne.
Le réflexe, en lisant cette séquence, est d'y voir une divergence puis un ralliement, et de conclure que le camp du non-stockage a gagné. C'est le contraire qui s'est produit. Les deux laboratoires ont posé le même diagnostic technique, à savoir que certains risques ne sont visibles qu'en regardant plusieurs requêtes ensemble, et aucun des deux n'y a renoncé. Ce qui a bougé en trois mois, c'est l'endroit où la donnée repose. Ce qui n'a jamais bougé, c'est le calcul qui la traverse et le signal qui en sort. Une entreprise qui a négocié sur le lieu de stockage a négocié sur la seule variable que ses fournisseurs étaient prêts à lui céder.
L'article du 20 août sur le contrôle qui existe sur le papier mais ne s'exécute pas portait sur les classificateurs que vous opérez vous-même. Celui du 15 juillet sur l'audit et le report de l'AI Act portait sur ce qu'un auditeur vient vérifier. Le sujet ici est l'angle mort entre les deux : ce que les classificateurs de votre fournisseur produisent à partir de vos données, où ces produits dérivés vont, et ce que vous pouvez en démontrer.
Ce que le Zero Data Retention recouvre exactement
La page de contrôles de données d'OpenAI est plus instructive que l'annonce, parce qu'elle décrit un mécanisme plutôt qu'une intention.
Deux types de données coexistent sur la plateforme. Les journaux de surveillance des abus, générés par défaut pour tout usage de l'API et conservés jusqu'à trente jours. L'état applicatif, persisté par certaines fonctionnalités pour accomplir la tâche demandée. Le ZDR agit sur le premier en excluant le contenu client de ces journaux, et modifie le comportement de deux endpoints en forçant le paramètre store à false sur /v1/responses et /v1/chat/completions, même quand la requête tente de le mettre à true.
Le point que les grilles d'achat manquent est la portée. Sur les vingt-quatre endpoints listés dans la documentation, onze sont éligibles au ZDR et treize ne le sont pas. Parmi les non éligibles figurent /v1/conversations, /v1/assistants et toute la famille /v1/threads, les magasins vectoriels, les fichiers, le fine-tuning, les évaluations, les traitements par lots et la génération vidéo, cette dernière étant même explicitement bloquée pour les requêtes sous ZDR. La documentation précise que ces endpoints peuvent continuer à stocker de l'état applicatif même quand le ZDR est activé pour l'organisation. Une entreprise qui a obtenu le ZDR et qui construit son agent sur l'API Conversations ou sur un magasin vectoriel géré n'a pas le régime qu'elle croit avoir.
Les deux natures de données
Journaux de surveillance des abus : les traces conservées par le fournisseur pour faire respecter ses politiques d'usage. Elles peuvent contenir du contenu client, mais aussi des métadonnées dérivées de ce contenu.
État applicatif : les données qu'une fonctionnalité doit persister pour fonctionner, par exemple le fil d'une conversation ou le contenu indexé d'un magasin vectoriel. Il obéit à une logique de produit, pas à une logique de conformité.
Signal dérivé : ce qu'un classificateur produit à partir de votre contenu sans être votre contenu, typiquement une catégorie d'activité et un niveau de sévérité. Il n'est ni un prompt ni une réponse, et c'est précisément pour cela qu'il échappe aux clauses écrites sur les prompts et les réponses.
Le ZDR n'est pas non plus un interrupteur. La documentation le décrit comme soumis à approbation préalable et à l'acceptation d'exigences supplémentaires, activable ensuite au niveau de l'organisation ou du projet. Et il transfère une responsabilité : les clients qui l'activent restent tenus de s'assurer que leurs utilisateurs respectent les politiques d'usage du fournisseur et de satisfaire aux obligations de modération et de signalement applicables. En obtenant le non-stockage, vous récupérez la charge de la surveillance.
Le signal dérivé, et les clauses qui le laissent passer
La phrase décisive de la documentation d'OpenAI tient en une ligne et ne parle pas de prompts. Les journaux de surveillance peuvent contenir du contenu client, écrit-elle, ainsi que des métadonnées dérivées de ce contenu, telles que les sorties de classificateurs. Cette seconde catégorie est celle qui survit au ZDR par construction, puisque le ZDR est écrit sur la première.
Private Safety Processing formalise ce partage. Quand un risque est identifié, OpenAI reçoit un signal étroitement défini indiquant le type d'activité concerné, et son personnel n'a pas accès au contenu client même lorsque celui-ci est signalé. Le schéma publié avec l'annonce est explicite sur la répartition : le client reçoit l'alerte complète et peut choisir de partager, OpenAI ne voit par ailleurs que la catégorie de l'alerte et sa sévérité. Le dispositif fonctionne indépendamment du lieu de stockage, que le contenu soit sur l'infrastructure du client ou sur celle d'OpenAI chiffrée avec des clés que le client détient et dont OpenAI n'a pas de copie.
Cette architecture est cohérente et le compromis qu'elle propose est défendable. Elle n'est pas vérifiable aujourd'hui. La revendication centrale, tracer des motifs à travers des interactions liées sans qu'aucun humain chez le fournisseur ne lise le contenu, repose sur un livre blanc technique annoncé pour septembre et non encore publié à la date de cet article. Le dispositif est en test avec des clients pilotes, dont Glean, Databricks, Abridge et Microsoft. Tant que le document n'est pas là, une équipe conformité qui écrit Private Safety Processing dans un dossier d'homologation documente une intention de conception, pas un mécanisme audité.
Deux clauses de la même page méritent d'être lues avant signature, et elles ne figurent dans aucune communication marketing. Sous l'intitulé Eyes Off, OpenAI se réserve le droit de rendre certains modèles inéligibles au ZDR pour des clients spécifiques, avec notification écrite préalable ; dans ce cas le contenu client est retenu dans les journaux de surveillance, mais exclu de la revue humaine sauf obligation légale. Sous l'intitulé Safety Retention, le même droit est réservé lorsque c'est raisonnablement nécessaire pour enquêter sur une activité à risque sévère ou la prévenir ; dans ce cas le contenu peut être retenu et faire l'objet d'une revue humaine.
Le ZDR n'est donc pas un état du compte, c'est un régime révocable modèle par modèle et client par client, dont les conditions de bascule sont écrites par le fournisseur seul. Il existe une troisième exception, plus ancienne et de nature différente : les images et fichiers soumis sont scannés à la réception, et une image dont le classificateur détecte un contenu pédocriminel potentiel est retenue pour revue manuelle même si le ZDR, la surveillance modifiée ou Eyes Off sont activés. Celle-là relève d'une obligation légale que personne ne conteste. Son intérêt pour un directeur technique est ailleurs : elle prouve que le principe admet des exceptions écrites, et donc qu'il en admettra d'autres.
Le régime d'Anthropic, dans sa version publiée, est plus lisible parce qu'il est plus explicite. Trente jours de rétention des prompts et des sorties sur les Covered Models, suppression automatique ensuite sauf signalement ou obligation légale, aucun personnel autorisé à lire par défaut, accès humain possible uniquement par un chemin contrôlé lorsque le contenu est signalé, revue limitée à un petit ensemble de relecteurs approuvés, et chaque accès enregistré dans un journal inviolable que les relecteurs ne peuvent ni supprimer ni modifier. La justification technique est nommée et sourcée : le jailbreaking Best-of-N, qui envoie des centaines de variantes légères d'un même prompt jusqu'à ce que l'une passe, n'est visible qu'en regardant les requêtes ensemble. Le livre blanc technique correspondant est publié sur le centre de confiance d'Anthropic depuis l'entrée en vigueur.
L'ironie de la séquence vaut d'être notée. Le fournisseur qui a imposé la rétention documente son mécanisme depuis juin ; celui qui a maintenu le non-stockage documentera le sien en septembre. La position contractuelle la plus favorable et la position la plus vérifiable ne sont pas chez le même acteur.
Une grille par flux, pas par fournisseur
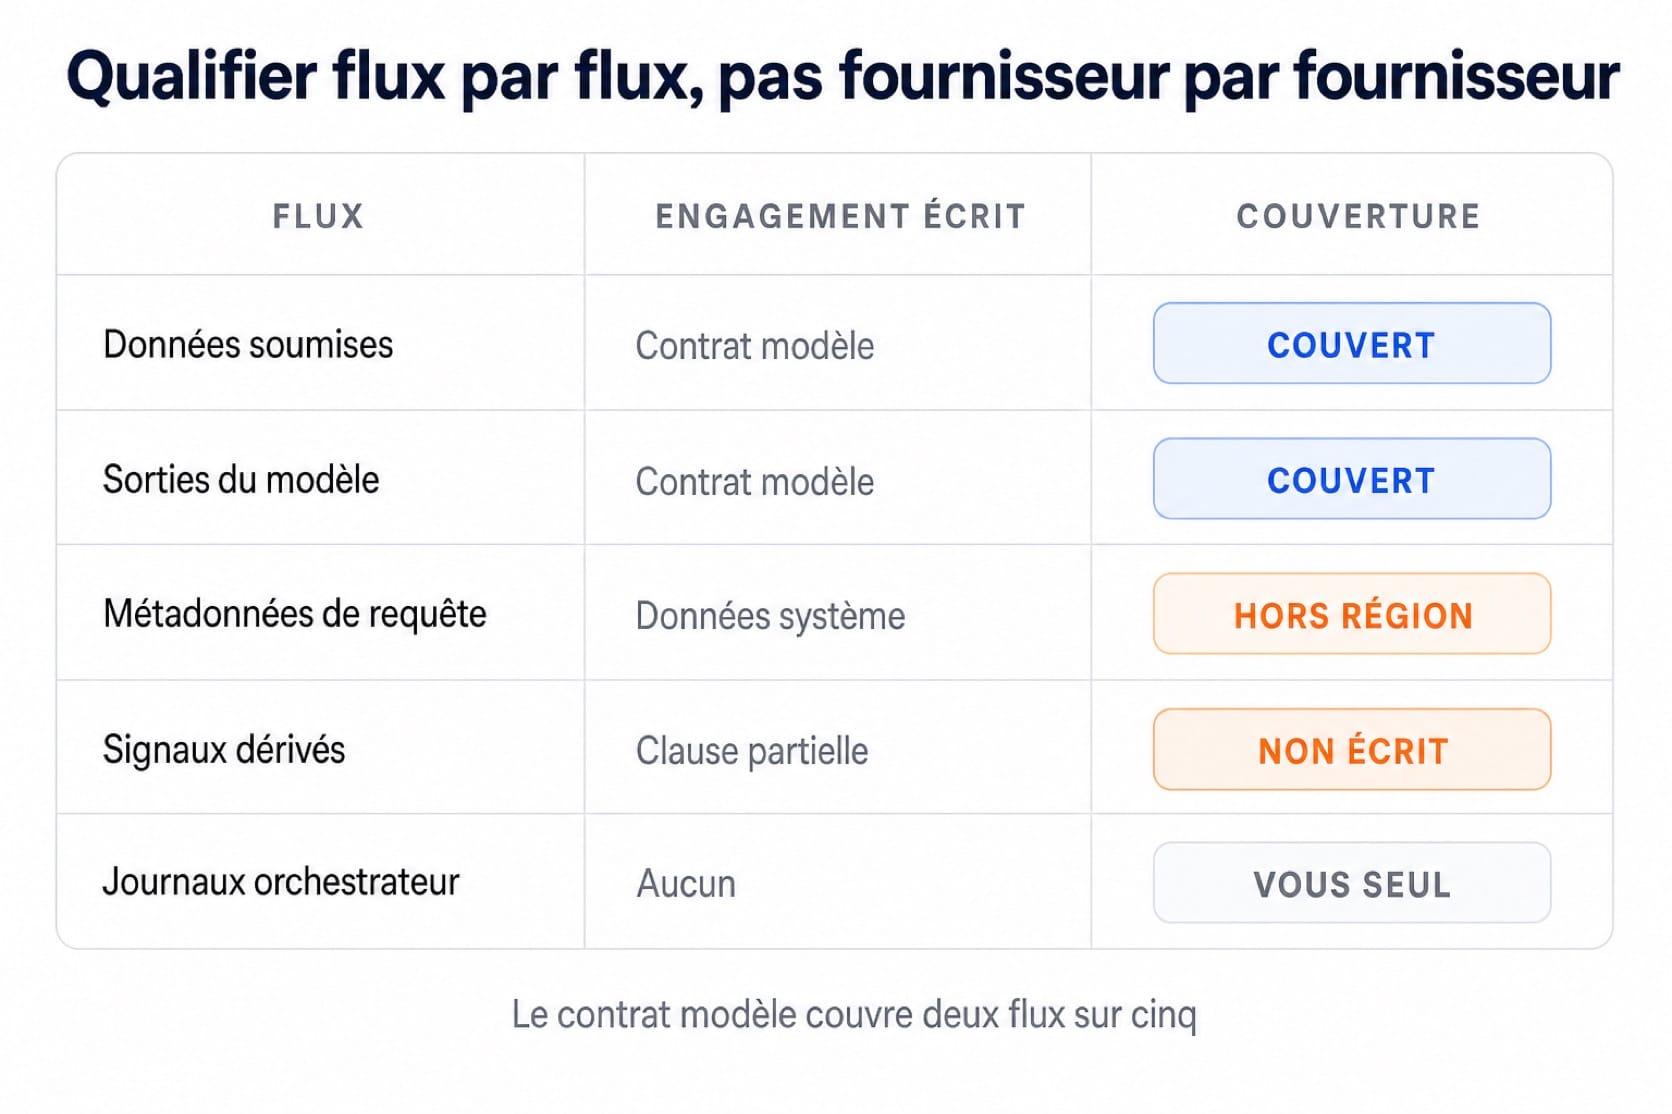
Sur le terrain, l'erreur récurrente est de traiter la rétention comme une case à cocher au niveau du fournisseur, alors que les engagements se prennent flux par flux et que les flux n'ont pas le même propriétaire. Cinq d'entre eux doivent être qualifiés séparément, chacun croisé avec un engagement écrit, une preuve exigible et une conséquence si l'engagement tombe.
Les données soumises, prompts, pièces jointes et contexte injecté. L'engagement existe, il est écrit, il est le mieux couvert des cinq. La preuve exigible est la liste nominative des endpoints couverts pour votre organisation, pas la page publique.
Les sorties du modèle. Même régime que les entrées chez les deux fournisseurs, avec la même limite d'endpoints. La question qui tranche est celle de l'état applicatif : une sortie qui transite par une fonctionnalité non éligible au ZDR est persistée par cette fonctionnalité, quelle que soit la clause signée sur les sorties.
Les métadonnées de requête. Identifiants, horodatages, volumétrie, schémas de sortie structurée. Chez OpenAI, la documentation de résidence des données les qualifie de données système et les exclut explicitement du périmètre régional, en nommant les schémas de sortie structurée parmi elles. Une entreprise qui a payé le supplément de résidence, facturé dix pour cent sur les modèles éligibles sortis après le 5 mars 2026, n'a pas régionalisé ces éléments.
Les signaux de sécurité dérivés. C'est le flux le moins couvert et le plus difficile à faire écrire. La bonne question à poser par écrit à votre fournisseur n'est pas quelles données vous conservez, mais quelle information dérivée de nos données quitte notre périmètre, sous quelle forme, à quelle fréquence, et pendant combien de temps la conservez-vous.
Les journaux de votre orchestrateur et de vos outils. Ils sont hors du contrat modèle et entièrement sous votre responsabilité. La documentation d'OpenAI le rappelle pour deux cas concrets : les données envoyées à un serveur MCP tiers relèvent de la politique de rétention de ce tiers, et les conteneurs hébergés utilisés par l'interpréteur de code écrivent de l'état temporaire sur leur système de fichiers pendant qu'ils sont actifs. Un agent qui appelle trois outils externes a trois politiques de rétention supplémentaires que personne n'a lues.
Le régime de rétention se comporte donc comme un critère de sélection et non comme une clause de fin de contrat, et l'argument n'est pas théorique. Lors du litige opposant OpenAI au New York Times, l'ordre de conservation qui a visé les échanges ChatGPT grand public excluait explicitement les clients API sous accord de non-rétention. La différence de régime a produit une différence juridique observable, et c'est le seul test grandeur nature dont ce marché dispose à ce jour.
À mettre en route cette semaine
Recensez les endpoints réellement appelés en production et confrontez-les à la liste d'éligibilité de votre fournisseur. Le chiffre utile n'est pas le nombre de vos projets couverts par un accord, c'est le nombre d'appels quotidiens qui partent vers un endpoint non éligible. Il se lit dans vos journaux de passerelle, pas dans le contrat.
Demandez par écrit la liste des signaux dérivés qui quittent votre périmètre, et non la liste des données stockées. Les deux questions ont des réponses différentes et une seule des deux figure spontanément dans les réponses commerciales.
Faites relire les clauses de réversibilité unilatérale par la direction juridique, en nommant les mécanismes qui permettent au fournisseur de retirer le régime de non-rétention pour un modèle ou pour votre organisation. La question à trancher est de savoir si la notification écrite préalable vous laisse un délai exploitable pour migrer, et ce que vous faites pendant ce délai.
Inscrivez la publication du livre blanc de septembre comme point de revue daté dans votre registre de conformité, avec un propriétaire et une date. Une promesse de documentation acceptée sans échéance devient une hypothèse permanente.
Classez vos cas d'usage par sensibilité de données et non par équipe propriétaire. C'est la seule découpe qui permette ensuite d'aligner un endpoint éligible, un modèle et une juridiction sur chaque flux, plutôt que d'appliquer le régime le plus strict à tout le monde et de voir les équipes le contourner.
Conclusion
La question qui structure un dossier de conformité IA n'est plus de savoir si le fournisseur conserve vos données, parce que les deux principaux convergent vers la même réponse et qu'elle vous sera bientôt donnée sans négociation. Elle est de savoir quelle information dérivée de vos données quitte votre périmètre, sous quelle forme, avec quelle preuve, et ce qui se passe le jour où le fournisseur exerce une clause qu'il a écrite seul. L'entreprise qui n'a pas de position écrite sur ce point n'en est pas dépourvue pour autant : elle a celle de son fournisseur.
Sources : As of August 2026
- [Primary] Offering Zero Data Retention for frontier models — OpenAI — 19 août 2026 — https://openai.com/index/offering-zero-data-retention-for-frontier-models/
- [Primary] Data controls in the OpenAI platform — OpenAI, documentation de l'API — consultée le 30 août 2026 — https://developers.openai.com/api/docs/guides/your-data
- [Primary] Data retention practices for Covered Models — Anthropic, Privacy Center — consultée le 30 août 2026 — https://privacy.claude.com/en/articles/15425996-data-retention-practices-for-covered-models
- [Primary] Covered Models — Anthropic, Help Center — consultée le 30 août 2026 — https://support.claude.com/en/articles/15425695-covered-models
- [Primary] How we're responding to The New York Times' data demands in order to protect user privacy — OpenAI — 2025 — https://openai.com/index/response-to-nyt-data-demands/
- [Primary] Best-of-N Jailbreaking — John Hughes et al. — arXiv:2412.03556 — https://arxiv.org/abs/2412.03556
- [Secondary] Anthropic Plans to Change Data Retention Policy for Advanced AI — Bloomberg — 20 août 2026 — https://www.bloomberg.com/news/articles/2026-08-20/anthropic-plans-to-change-data-retention-policy-for-advanced-ai
- [Secondary] Anthropic changes data retention policy after enterprise pushback — Maximilian Schreiner, The Decoder — 21 août 2026 — https://the-decoder.com/anthropic-changes-data-retention-policy-after-enterprise-pushback/
- [Secondary] OpenAI previews Private Safety Processing to keep zero data retention — Ana Maria Constantin, The Next Web — 20 août 2026 — https://thenextweb.com/news/openai-zero-data-retention-private-safety-processing
- [Secondary] OpenAI previews zero-retention safety system as Anthropic requires data logs — Axios — 19 août 2026 — https://www.axios.com/2026/08/19/openai-previews-zero-retention-safety-system-as-anthropic-requires-data-logs
Comments ()