Le rabais de 45% est dans l'annonce, sa condition est dans le guide de migration
Le 1er septembre 2026, Anthropic a publié Claude Fable 5.1 et Claude Mythos 5.1 au même prix liste que la génération précédente, 10 dollars le million de tokens en entrée et 50 dollars en sortie, en divisant par quatre le prix d'une lecture de cache, de 1 dollar à 0,25 dollar le million. L'annonce chiffre l'effet attendu sur la facture : environ 25% d'économie sur une charge classique, jusqu'à 45% sur une charge de codage ou d'agent intensive. La méthode figure en note de bas de page, et elle est plus honnête que la moyenne du secteur : coût indexé des mêmes charges exécutées sur Fable 5 puis sur Fable 5.1, à tarification à l'usage, à effort par défaut, mesuré sur quatre semaines d'usage réel en août 2026. VentureBeat a relayé les deux chiffres le jour de la sortie, la documentation produit les confirme ligne par ligne.
Devant une remise de cette taille, le réflexe est de changer l'identifiant du modèle et d'attendre la prochaine facture. Les prix publiés racontent autre chose, et l'arithmétique est à la portée de n'importe quel responsable de plateforme. Une écriture de cache coûte 12,50 dollars le million sur une fenêtre de cinq minutes, soit un quart de plus qu'une entrée fraîche. Tant que la lecture valait 1 dollar, une écriture coûtait douze fois et demie une lecture. À 0,25 dollar, elle en coûte cinquante. La baisse n'a donc pas seulement réduit le coût de porter du contexte d'un tour au suivant, elle a quadruplé l'écart entre une architecture qui garde son préfixe intact et une architecture qui le réécrit à chaque tour. Le rabais récompense une discipline, pas une montée de version.
Cette discipline a un nom dans la documentation et trois conditions d'entrée, listées non pas dans le billet d'annonce mais dans le guide de migration, où personne ne va chercher un argument budgétaire. L'usage forcé d'un outil renvoie désormais une erreur. Les modèles antérieurs ne savent plus lire les blocs de raisonnement produits par Fable 5.1. Et toute modification d'un tour antérieur invalide les blocs de raisonnement qui le suivent. L'article du 1er septembre sur le préavis de retrait devenu le calendrier réel du fournisseur traitait de la sortie contrainte d'une version. Celui-ci traite l'entrée volontaire dans la suivante, et de ce qu'elle coûte quand votre boucle d'agent a été écrite en supposant que l'historique vous appartenait.
Ce que le prix du cache a vraiment changé
Sur la plupart des modèles de la famille, une lecture de cache coûte un dixième du prix d'entrée de base. Sur Fable 5.1, elle en coûte un quarantième, 0,025 fois le prix de base selon la documentation produit. C'est ce rapport, et pas le pourcentage de remise, qui décrit ce qui a changé. Porter cent mille tokens de contexte d'un tour au suivant coûtait un dollar par cent appels, il en coûte vingt-cinq centimes. Sur une session d'agent de deux heures qui relit son préfixe à chaque tour d'outil, l'écart devient visible dans le rapport de consommation avant de l'être dans la facture.
Le reste de la grille n'a pas bougé, et c'est là que se joue la partie. Les écritures restent à 12,50 dollars le million pour une rétention de cinq minutes et 20 dollars pour une heure. Le minimum cachable reste de 512 tokens. La fenêtre de contexte est de un million de tokens, au tarif standard sur toute son étendue, avec 128 000 tokens de sortie maximum. Rien de tout cela n'est nouveau. Ce qui est nouveau, c'est le poids relatif de l'erreur : chaque fois que votre préfixe change, vous ne renoncez pas seulement à la remise, vous payez une réécriture à 12,50 dollars là où une relecture vous aurait coûté 0,25. Pour le segment concerné, la facture sort 25% au-dessus de ce qu'aurait coûté le même appel sans cache du tout.
Les mots du cache de prompt
Préfixe : la partie d'une requête qui précède le point de cache, soit le prompt système, le tableau d'outils et tous les messages antérieurs. Le cache est indexé sur les octets de ce préfixe : un seul caractère qui change le fait repartir de zéro.
Écriture de cache : premier passage d'un préfixe, facturé plus cher qu'une entrée fraîche parce qu'il stocke le calcul intermédiaire. Sur Fable 5.1, 12,50 dollars le million pour cinq minutes de rétention, 20 dollars pour une heure.
Lecture de cache : réutilisation d'un préfixe déjà écrit et encore valide. 0,25 dollar le million sur Fable 5.1, contre 1 dollar sur Fable 5.
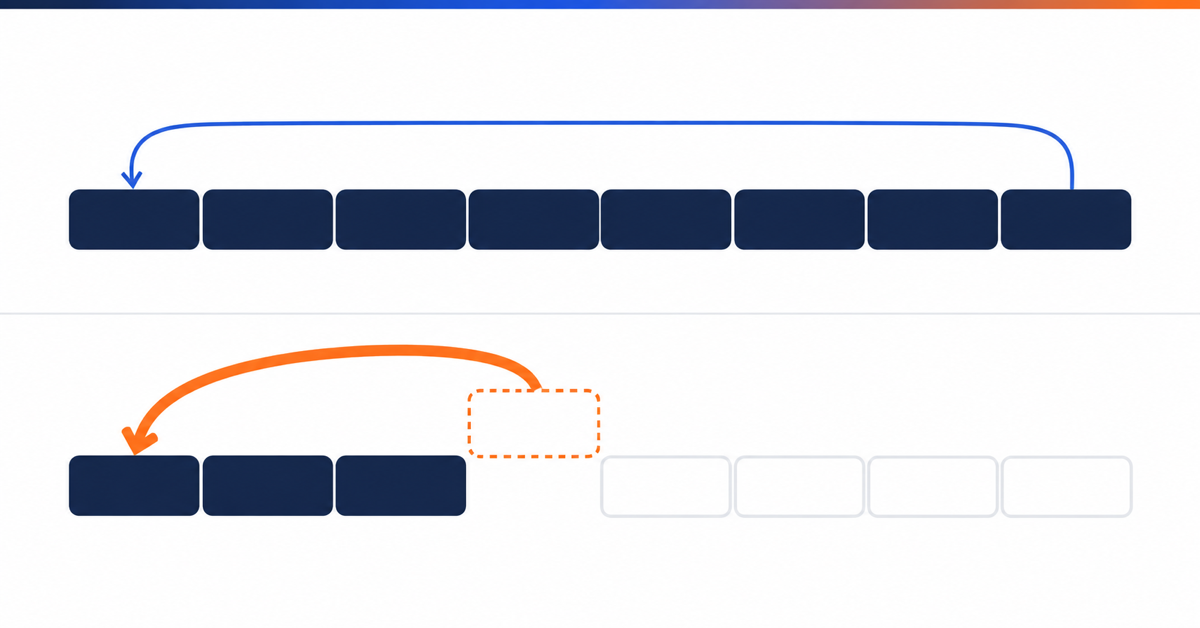
Append-only : discipline d'écriture où l'on ajoute des tours à la fin de l'historique sans jamais toucher à ce qui précède. C'est la seule forme d'historique dont le préfixe reste valide d'un appel au suivant.
L'autre élément à retenir de la note de méthode, c'est l'effort par défaut. Les 25% et les 45% ont été mesurés à effort par défaut, qui est le niveau haut sur ce modèle. Si vos appels tournent à un effort inférieur, votre mélange entre tokens de raisonnement et tokens de contexte réutilisé n'est pas celui de la mesure, et votre économie non plus. L'inverse est vrai aussi : un paramétrage qui produit beaucoup de raisonnement et réutilise peu de contexte verra passer la remise sans en profiter, puisqu'elle porte sur la relecture, pas sur la production.
Trois changements qui invalident des patterns courants
Le premier est net et se détecte en une journée de tests. L'usage forcé d'un outil n'est plus pris en charge : tool_choice en {"type": "any"} ou en {"type": "tool", "name": "..."} renvoie un code 400 avec un invalid_request_error, sur l'API Messages, sur l'API de traitement par lots et sur le point d'entrée de comptage de tokens. Seuls auto et none subsistent. Pour les équipes qui obtenaient une sortie structurée en forçant un outil d'extraction, le chemin de remplacement est documenté : une instruction explicite dans le tour utilisateur, des outils déclarés en mode strict, ou un basculement vers les sorties structurées. Ce n'est pas une ligne de code, c'est une réécriture de prompt et une nouvelle campagne d'évaluation sur chaque chaîne concernée.
Le deuxième est asymétrique, et c'est son asymétrie qui pose problème. Fable 5.1 sait lire les blocs de raisonnement produits par Mythos 5.1, par Opus 5, par Fable 5 et par les générations antérieures. Aucun de ces modèles ne sait lire les blocs qu'il produit lui. Quand une conversation bascule de Fable 5.1 vers un modèle plus ancien, par un routeur, une reprise sur erreur ou un repli de capacité, les blocs de raisonnement sont retirés en silence avant que l'ancien modèle ne les voie. Les tokens retirés ne sont pas facturés, ce qui est correct, mais rien dans le code appelant ne signale que la conversation a perdu sa continuité de raisonnement. Toute architecture de repli multi-modèle hérite donc d'un mode dégradé invisible, dont le symptôme sera une réponse moins bonne sans message d'erreur.
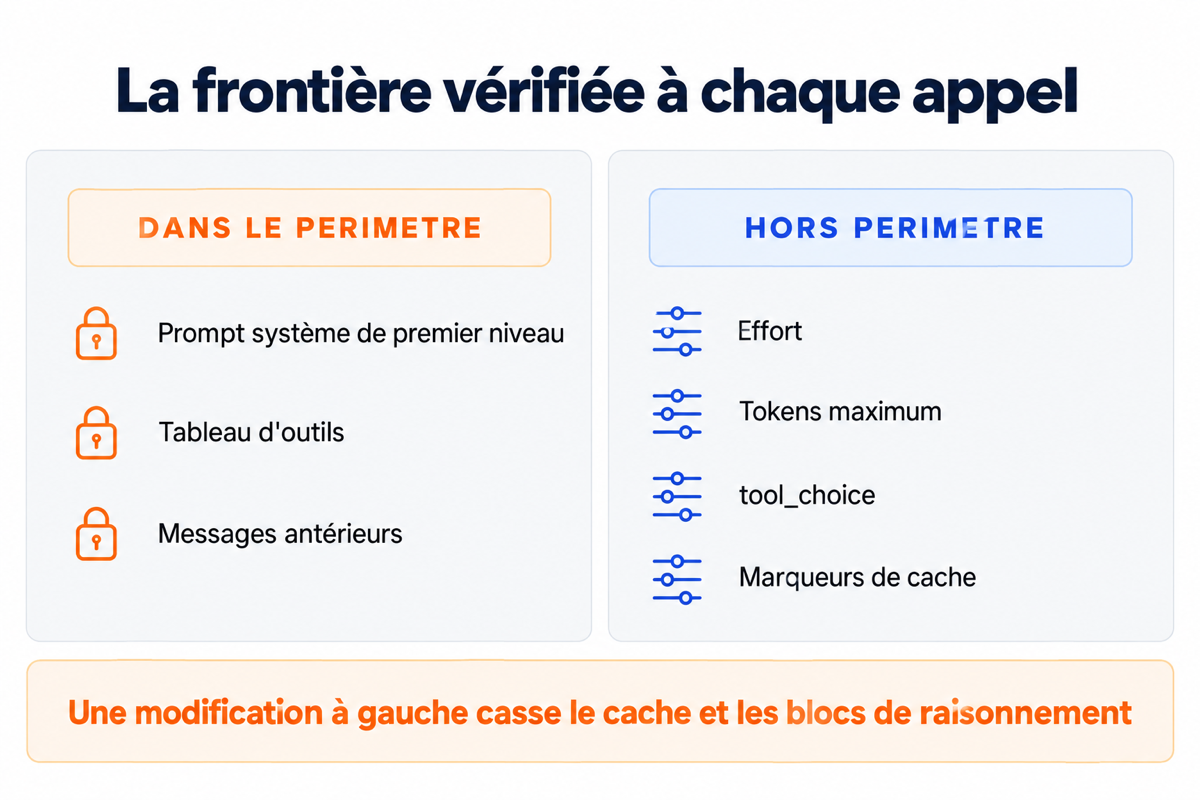
Le troisième est celui qui déplace la décision du niveau code au niveau architecture. Depuis Fable 5.1, chaque bloc de raisonnement porte une signature cryptographique qui encode le modèle émetteur et le préfixe de conversation au moment de l'émission, soit le prompt système, le tableau d'outils et tous les messages antérieurs. L'API vérifie cette signature à chaque appel. Si le préfixe a changé, la requête part en 400 avec un message qui nomme le bloc fautif, ou laisse tomber les blocs concernés si vous l'avez explicitement demandé. La documentation est claire sur le périmètre vérifié : le prompt système de premier niveau, le tableau d'outils, les messages antérieurs. L'effort, le nombre de tokens maximum, tool_choice, les métadonnées et les marqueurs de cache n'en font pas partie et peuvent bouger librement.
Ce que vérifie la liaison d'un bloc de raisonnement
Bloc de raisonnement : trace de calcul intermédiaire renvoyée par le modèle et que vous repassez dans l'historique au tour suivant pour éviter qu'il reparte de zéro. Sur Fable 5.1 l'affichage de son contenu est omis par défaut.
Liaison de bloc : signature portée par chaque bloc, qui encode le modèle émetteur et le préfixe exact qui le précédait. Elle sert à vérifier deux choses, que le modèle courant a le droit de lire ce bloc, et que rien n'a bougé avant lui.
prefix_mismatch_behavior : réglage à deux valeurs, derrière un en-tête beta. En `error`, l'appel échoue en 400 sur le premier bloc fautif. En `drop_block`, l'appel passe, le bloc fautif et tous les suivants sont retirés, non facturés, et listés dans le tableau `input_transformations` de la réponse.
Une précision de calendrier change la façon de lire tout ce qui précède. L'application du contrôle de préfixe est obligatoire pour les comptes créés à partir du 31 août 2026 à zéro heure UTC. Pour les comptes antérieurs, le contrôle tourne mais ne bloque pas : les blocs qui ne correspondent plus atteignent quand même le modèle, à moins que la requête ne demande explicitement l'application. Les reprises secondaires de l'annonce ne mentionnent pas cette distinction, et c'est elle qui décide si vous découvrez le sujet par une erreur 400 en production ou par une dérive de qualité silencieuse sur une facture qui ne baisse pas.
Le préfixe de contexte n'est plus un détail d'implémentation
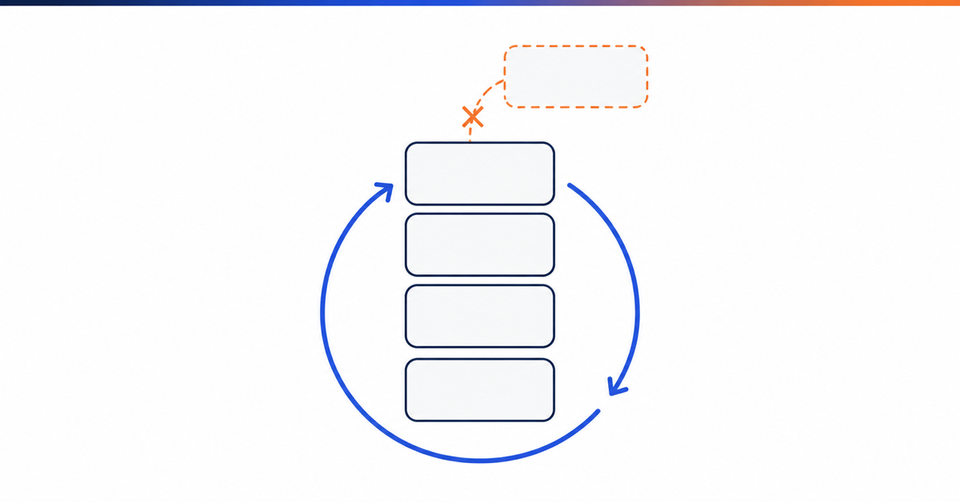
La liste des gestes qui cassent un préfixe mérite d'être lue par la personne qui a écrit votre boucle d'agent, pas par celle qui négocie le contrat. Modifier, réordonner ou retirer un tour antérieur casse. Supprimer d'anciens résultats d'outil pour faire de la place casse. Retirer un tour du milieu de la transcription casse. Une compaction faite côté client, qui remplace les vieux tours par un résumé tout en gardant les tours récents tels quels, casse, y compris quand elle tourne en tâche de fond. Reconstruire le prompt système de premier niveau entre deux requêtes casse. Reconstruire le tableau d'outils entre deux requêtes casse. Injecter un contenu que vous ne conservez pas, un rappel de consigne ajouté puis retiré au tour suivant, casse. Et une image ou un document servi par une URL qui ne renvoie pas les mêmes octets au second appel casse aussi.
Sur le terrain, ce n'est presque jamais la compaction qui se fait prendre en premier, parce qu'elle est connue, documentée et surveillée. Ce qui se fait prendre, c'est une ligne de prompt système rendue à partir d'un gabarit qui y insère la date du jour, l'heure, le nom de l'utilisateur ou un identifiant de session. Les octets du préfixe changent à chaque requête, le cache ne sert jamais, et le rapport de consommation ne montre que des écritures. Dans les déploiements matures, cette ligne survit souvent des mois, parce qu'elle n'a jamais produit d'erreur et que le coût du cache manqué était noyé. À un quarantième du prix d'entrée pour une lecture, elle devient la ligne la plus chère de votre prompt.
Les gestes qui préservent le préfixe sont documentés avec la même précision, et c'est la bonne nouvelle du dossier. Un historique strictement additif, où vous repassez les tours antérieurs exactement tels qu'ils ont été envoyés et reçus, reste valide. Retirer des blocs de raisonnement en partant des plus anciens, ou tous, reste valide, alors qu'en retirer un du milieu crée un trou qui casse. Déplacer ou ajouter des marqueurs de cache reste valide. Changer l'effort entre deux requêtes reste valide, et depuis la mise en place de l'effort par message il peut même varier en cours de conversation sans invalider le cache. La compaction et l'édition de contexte côté serveur n'invalident jamais les blocs de raisonnement, contrairement à leur équivalent côté client.
Pour les trois besoins qui poussaient les équipes à réécrire l'historique, il existe désormais une contrepartie native. Un changement de consigne en cours de session passe par un message de rôle système ajouté dans le tableau de messages, au lieu d'une reconstruction du prompt système de premier niveau. Un rappel valable pour un seul tour passe par un message système à portée de tour, avec clear_at réglé sur next_user_message : le message cesse de s'afficher dès qu'un tour utilisateur plus récent existe, ne coûte plus de tokens, et reste physiquement dans le tableau, ce qui préserve la structure attendue par les signatures. Un changement d'outillage passe par des blocs d'ajout et de retrait d'outil, voire par une définition d'outil posée en cours de conversation, au lieu d'une réécriture du tableau d'outils. Chacune de ces trois voies est derrière un en-tête beta daté, ce qui est une information de planning autant que de code.
Ce que la remise suppose en plus du code
Deux conditions n'ont rien à voir avec vos patterns de prompt et peuvent pourtant arrêter net un dossier en environnement régulé. Fable 5.1 et Mythos 5.1 sont désignés Covered Models et exigent une rétention de données de trente jours. La rétention nulle n'est donc pas disponible sur ces modèles sans autorisation expresse d'Anthropic, et une requête émise par une organisation ou un espace de travail qui n'a pas activé la rétention repart en 400. Ce n'est pas une nouveauté de la version 5.1, puisque Fable 5 et Mythos 5 portaient déjà la même désignation, et la documentation décrit une parade par espace de travail : activer la rétention de trente jours sur un espace donné tout en conservant la rétention nulle ailleurs. Mais si votre dossier de conformité a été instruit sur un modèle non couvert, la remise de 45% ne vous est pas adressée tant que ce point n'est pas rouvert.
L'accès lui-même n'est pas symétrique entre les deux modèles annoncés ensemble. Fable 5.1 est disponible pour tous les clients, sur l'API directe comme sur les trois grands clouds. Mythos 5.1 est réservé aux participants d'un programme d'accès encadré. Une annonce qui nomme deux modèles ne vous ouvre donc qu'un chemin d'achat sur les deux, et c'est le genre de détail qui se perd entre la lecture d'un billet et la rédaction d'une note interne.
Le contexte de marché ajoute une pression que ce dossier technique ne crée pas mais qu'il illustre bien. Le 6 septembre 2026, CNBC a donné un nom à ce que vivent les acheteurs face à cette cadence, la model fatigue, après une semaine où quatre laboratoires frontière ont livré en quelques jours. La conséquence pratique est moins le choix du modèle que la répétition de l'exercice : si chaque version mineure embarque des changements cassants au niveau de l'API, le coût de migration devient une ligne récurrente et non un investissement ponctuel. C'est l'argument le plus solide en faveur d'une couche d'exécution qui ne suppose rien du fournisseur, et le meilleur test de cette couche est précisément celui-ci : combien de fichiers devez-vous ouvrir pour retirer un tool_choice forcé et rendre votre historique additif.
À mettre en route cette semaine
Lancez une recherche sur tool_choice dans l'ensemble de vos dépôts et comptez les occurrences en any et en tool. Chacune est une erreur 400 garantie le jour où vous changez l'identifiant de modèle, et chacune demande une réécriture de prompt plus une évaluation, pas un remplacement de chaîne. Ce décompte est le seul chiffrage crédible du coût de migration, et il s'obtient en une demi-journée.
Instrumentez avant de budgéter, en profitant d'une fenêtre qui ne durera pas. Si votre compte a été créé avant le 31 août 2026, ajoutez l'en-tête beta de contrôle de liaison et relevez le tableau input_transformations sur chaque réponse en préproduction. Les entrées de type thinking_mismatch_allowed vous disent exactement combien de vos requêtes auraient échoué sous application obligatoire, sur du trafic réel, sans rien casser. C'est un audit gratuit de vos patterns de mutation d'historique, et il vous donne le pourcentage de la remise que votre architecture peut réellement encaisser.
Faites la revue des endroits où votre prompt système et votre tableau d'outils sont rendus par un gabarit. Cherchez les horodatages, les noms d'utilisateur, les identifiants de session et les compteurs insérés dans un préfixe censé rester stable. Déplacez chacun dans le tour le plus récent, et remplacez vos rappels par tour par un message système à portée de tour. Mesurez le taux de lecture de cache avant et après sur la même charge : c'est la seule preuve qui tienne devant un comité.
Reprenez votre compaction côté client et posez la question ouvertement : pouvez-vous la remplacer par l'édition de contexte côté serveur, qui n'invalide pas les blocs de raisonnement. Si la réponse est non pour des raisons de maîtrise ou de portabilité, écrivez-la, chiffrez le cache perdu avec le point d'entrée de comptage de tokens, et assumez ce coût comme un choix d'architecture documenté plutôt que comme une surprise de fin de mois.
Portez enfin la question de la rétention à votre responsable conformité avant de planifier la bascule, pas après. La réponse utile n'est pas oui ou non sur l'organisation entière, c'est de savoir si un espace de travail dédié avec rétention de trente jours est acceptable pour le périmètre que vous voulez migrer en premier.
Conclusion
La sortie du 1er septembre sera retenue comme une baisse de prix, et elle en est une : la lecture de cache a vraiment perdu 75% de son coût, et l'économie de 25% à 45% est appuyée sur une mesure dont la méthode est publiée. Ce que la même documentation dit avec moins d'emphase, c'est que cette économie se gagne sur la relecture d'un préfixe intact, et qu'une boucle d'agent qui réécrit son historique à chaque tour paie désormais une écriture là où elle aurait pu payer un cinquantième. La stabilité du préfixe de contexte a cessé d'être une optimisation pour devenir une propriété d'architecture, avec un contrôle serveur qui la vérifie et une date d'application déjà passée pour les comptes récents. Le travail à faire n'est pas de choisir entre les deux versions du modèle, c'est de savoir, chiffre en main, quelle part de la remise votre code est capable d'encaisser.
Sources : As of Septembre 2026
- [Primary] Introducing Claude Fable 5.1 and Claude Mythos 5.1, prix liste inchangés, lectures de cache à 0,25 dollar, économie de 25% et jusqu'à 45%, méthode de mesure sur quatre semaines d'août 2026 — Anthropic — 1er septembre 2026 — https://www.anthropic.com/claude-fable-and-mythos-5-1
- [Primary] What's new in Claude Fable 5.1, grille tarifaire complète, lecture de cache à 0,025 fois le prix d'entrée, minimum cachable de 512 tokens, restriction de tool_choice, effort par message — Claude Platform Docs, Anthropic — 2026 — https://platform.claude.com/docs/en/models/fable-5-1/whats-new-fable-5-1
- [Primary] Migrating to Claude Fable 5.1 and Claude Mythos 5.1, trois changements cassants, codes d'erreur, calendrier d'application au 31 août 2026, exigence de rétention — Claude Platform Docs, Anthropic — 2026 — https://platform.claude.com/docs/en/models/fable-5-1/migration-guide
- [Primary] Preserved thinking, liaison de bloc, périmètre de préfixe vérifié, listes des gestes sûrs et non sûrs, prefix_mismatch_behavior, tableau input_transformations — Claude Platform Docs, Anthropic — 2026 — https://platform.claude.com/docs/en/build-with-claude/preserved-thinking
- [Primary] Mid-conversation system messages and tool changes, messages système en cours de conversation, clear_at, blocs d'ajout et de retrait d'outil, en-têtes beta — Claude Platform Docs, Anthropic — 2026 — https://platform.claude.com/docs/en/build-with-claude/mid-conversation-system-messages
- [Primary] Context editing, édition de contexte côté serveur, interaction avec le cache et avec les blocs de raisonnement préservés — Claude Platform Docs, Anthropic — 2026 — https://platform.claude.com/docs/en/build-with-claude/context-editing
- [Primary] API and data retention, désignation Covered Models pour Fable 5.1, Mythos 5.1, Fable 5 et Mythos 5, rétention de trente jours, indisponibilité de la rétention nulle, parade par espace de travail — Claude Platform Docs, Anthropic — 2026 — https://platform.claude.com/docs/en/manage-claude/api-and-data-retention
- [Secondary] Anthropic's Claude Fable 5.1 and Mythos 5.1 arrive with a 75% cost reduction for Fable cache reads, confirmation du passage de 1 à 0,25 dollar et des 25% et 45% — VentureBeat, Carl Franzen — 1er septembre 2026 — https://venturebeat.com/technology/anthropics-claude-fable-5-1-and-mythos-5-1-arrive-with-a-75-cost-reduction-for-fable-cache-reads
- [Secondary] Anthropic launches Claude Fable 5.1 with cheaper cached inputs and new migration requirements, reprise des trois changements cassants documentés — MLQ.ai — 4 septembre 2026 — https://mlq.ai/news/anthropic-launches-claude-fable-51-with-cheaper-cached-inputs-and-new-migration-requirements/
- [Secondary] Anthropic Fable 5.1 Keeps $10/$50 Price, Cuts Cache Reads 75%, origine de la mesure dans quatre semaines d'usage d'août 2026 à effort par défaut — Implicator.ai — septembre 2026 — https://www.implicator.ai/anthropic-fable-5-1-same-price-cache-reads-cut/
- [Secondary] Model fatigue sets in as AI labs race to roll out new versions at frenetic pace — CNBC — 6 septembre 2026 — https://www.cnbc.com/2026/09/06/meta-google-openai-anthropic-ai-model-fatigue.html
Comments ()